
L'abonnement est la partie la moins chère d'un outil de codage IA. Que vous payiez 20 $, 100 $ ou 200 $ par mois, les coûts les plus importants n'apparaissent pas sur la facture. Ils arrivent plus tard, sous forme de code qui passe la revue et casse en production, d'applications qui laissent fuiter les données de leurs utilisateurs, de plus de code que quiconque ne peut en relire, d'agents aux accès trop larges qui suppriment des bases de données de production, et d'ingénieurs en burnout.
Je suis ingénieur logiciel dans une grande entreprise tech et j'utilise ces outils tous les jours. Je ne suis pas anti-IA. Mais j'ai moi-même rencontré beaucoup des problèmes décrits dans cet article, et en 2026 il existe enfin assez de données pour les chiffrer.
En bref
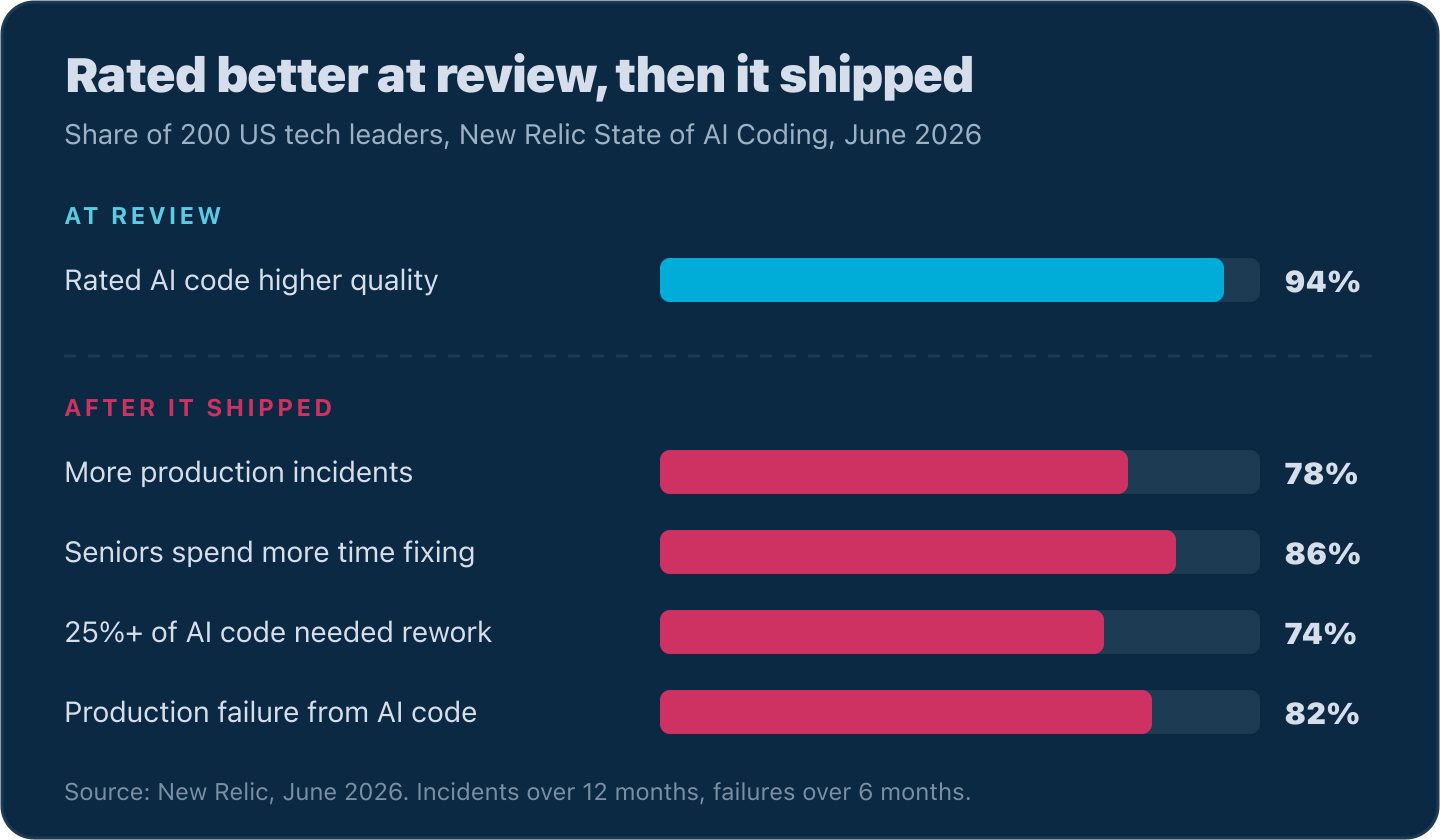
- Le code IA a meilleure allure en revue qu'en production. Dans l'enquête de New Relic de juin 2026 auprès de 200 responsables tech américains, 94 % jugeaient le code IA de meilleure qualité que le code écrit par des humains au moment de la revue. 82 % pouvaient citer une panne en production causée par du code IA au cours des six mois précédents (New Relic, 2026).
- Les agents dotés d'identifiants trop larges détruisent vite. Un agent Cursor utilisant Claude a supprimé la base de données de production de PocketOS en 9 secondes environ, et un
terraform destroylancé par Claude a effacé 2,5 ans de données de cours de DataTalks.Club. Dans les deux cas, des permissions restreintes auraient arrêté l'agent là où ses instructions ont échoué. - La revue est le nouveau goulot d'étranglement. À mesure que l'adoption de l'IA progressait chez environ 22 000 développeurs, le temps médian passé en revue de PR a augmenté de 441 % et le nombre de bugs par développeur de 54 % (Faros AI, 2026).
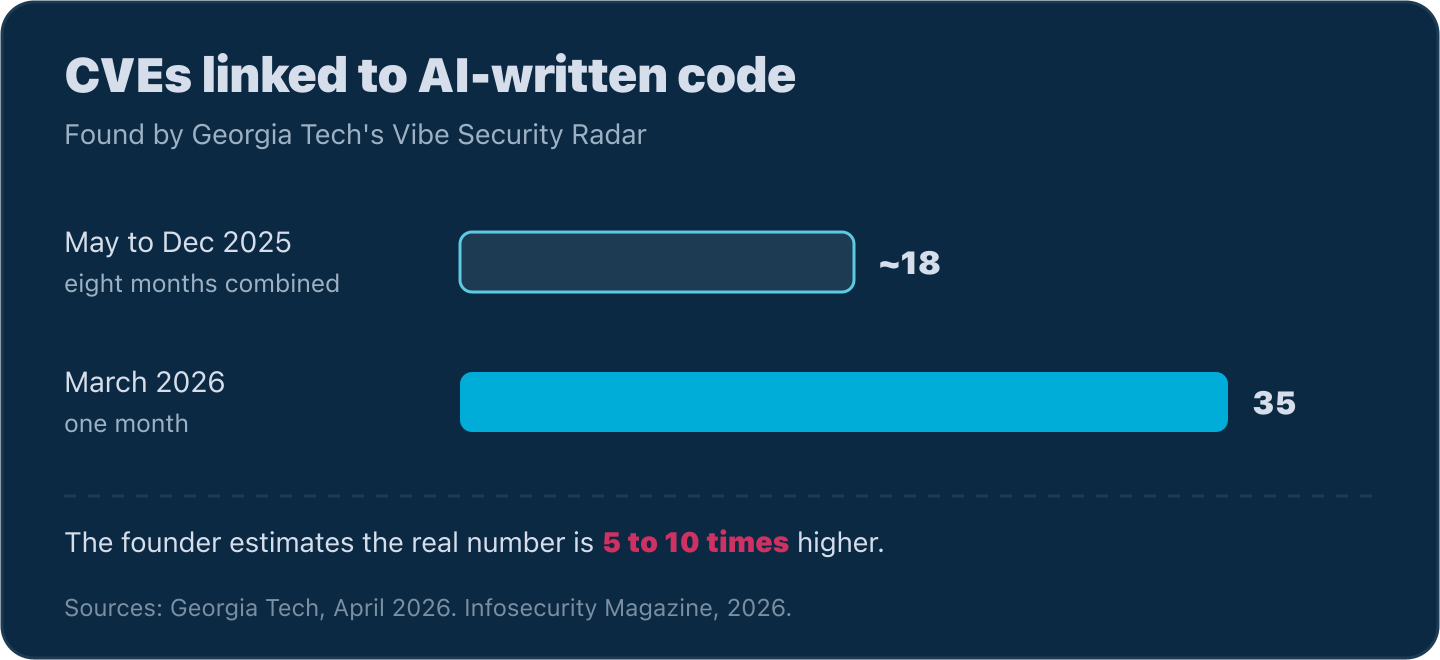
- Les failles de sécurité se multiplient. Des chercheurs de Georgia Tech ont relié 35 CVE à du code écrit par l'IA rien qu'en mars 2026, contre environ 18 de mai à décembre 2025 (Georgia Tech, 2026).
- Les personnes paient aussi. Les juniors qui ont appris avec l'IA ont obtenu 50 % à un quiz de compréhension, contre 67 % pour ceux qui ont codé à la main (Anthropic, 2026), et une enquête auprès de 442 développeurs a montré que l'adoption de l'IA augmente le burnout en alourdissant les exigences du poste (Feng et al., 2026).
Pourquoi le code IA passe-t-il la revue puis casse-t-il en production ?
Le code IA passe la revue parce qu'il a l'air propre. Il casse en production parce que l'agent qui l'a écrit ne sait pas comment votre système se comporte sous un trafic réel, ni pourquoi le code existant est écrit de cette façon.
En juin 2026, New Relic a publié son enquête State of AI Coding menée auprès de 200 responsables tech américains (New Relic, 2026). Au stade de la revue, 94 % jugeaient le code généré par l'IA de meilleure qualité que le code écrit par des humains, et 33 % le jugeaient même bien meilleur. Une fois ce code livré, les réponses se sont inversées :
- 78 % ont signalé davantage d'incidents en production au cours des 12 derniers mois
- 86 % ont déclaré que les ingénieurs seniors passent plus de temps à corriger du code
- 74 % ont déclaré qu'au moins un quart de leur code généré par l'IA avait nécessité un remaniement important
- 82 % pouvaient citer une panne en production au cours des six derniers mois causée par du code IA
Si le code est meilleur en revue, pourquoi continue-t-il de casser ? Je vois quatre raisons dans mon propre travail.
L'agent ne connaît pas le système. Il ne voit pas combien de trafic un service absorbe, quels jours sont particulièrement chargés, ni quelle dépendance en aval tombe la première. Rien de tout cela ne figure dans le diff.
Il ne sait pas pourquoi le code est écrit ainsi. Toute base de code mature contient des conditions étranges. Le flux de paiement comporte peut-être une vérification bizarre parce qu'un développeur précédent est tombé sur un bug du prestataire et l'a contourné. Un humain qui lit ce code irait demander à la personne qui l'a écrit. L'agent, lui, ne demande pas. Il fait une supposition et continue, et cette supposition est souvent fausse.
Les relecteurs deviennent aveugles face aux gros diffs. Quand un agent produit des centaines de lignes d'un coup, le relecteur se sent submergé. Au bout d'un moment, vous arrêtez de lire attentivement, et du code est approuvé parce qu'il a l'air correct. Les cas limites qu'un ingénieur qui travaille dans ce code depuis des années gérerait sans y penser sont justement ceux que personne ne vérifie.
La dette d'agent s'accumule. C'est du code IA bâclé qui part en production et n'est jamais nettoyé. Comme toute dette technique, elle grossit, et elle finit par se transformer en incident de production.
Que se passe-t-il quand l'outil IA lui-même se dégrade ?
La productivité de votre équipe baisse, et c'est difficile à remarquer. En mars et avril 2026, des développeurs se sont plaints pendant des semaines que Claude Code était devenu moins bon. Stella Laurenzo, directrice du groupe IA chez AMD, a analysé 6 852 sessions Claude Code et a constaté que l'agent lisait beaucoup moins de code avant de faire des modifications. Il est passé de 6,6 lectures de fichiers par modification à 2,0 (GitHub issue #42796, 2026).
Le postmortem d'Anthropic a attribué cette baisse à trois changements qu'elle avait déployés, dont un bug de cache qui effaçait le raisonnement du modèle à chaque tour. Ce bug « a franchi plusieurs revues de code humaines et automatisées, ainsi que les tests unitaires, les tests de bout en bout, la vérification automatisée et le dogfooding » (Anthropic, 2026).
Pensez à ce que cela signifie pour une entreprise de plusieurs centaines d'ingénieurs qui s'appuient sur ces outils. Pendant des semaines, toute l'organisation d'ingénierie tourne à productivité réduite, et presque personne ne s'en aperçoit. Quand un agent fonctionne mal, on hausse les épaules en se disant « c'est de l'IA, ça arrive ».
Anthropic affirme que rien de tout cela n'était intentionnel, et je la crois. Cela m'a quand même mis mal à l'aise. Quand votre équipe dépend d'un modèle d'Anthropic, d'OpenAI ou de n'importe qui d'autre, c'est le fournisseur qui décide du niveau de ce modèle aujourd'hui. Si un fournisseur choisissait un jour de réduire la qualité, les développeurs qui dépendent le plus de l'outil seraient les plus touchés. Et une poignée d'entreprises détermine désormais la qualité d'une grande partie du nouveau code écrit dans le monde.
Un agent IA peut-il supprimer votre base de données de production ?
Oui. C'est arrivé dans au moins trois cas rendus publics au cours de l'année écoulée, et à chaque fois l'agent disposait de bien plus d'accès que sa tâche ne l'exigeait.
PocketOS : la production effacée en 9 secondes
En avril 2026, un agent IA dans Cursor, utilisant Claude Opus 4.6 d'Anthropic, travaillait sur une tâche dans l'environnement de staging de PocketOS et s'est heurté à un problème d'identifiants. Il est parti à la recherche d'identifiants et a trouvé un token d'API Railway dans un fichier sans rapport. Le token avait été créé pour gérer des domaines personnalisés, mais sa portée n'était pas limitée. Quiconque le détenait pouvait tout faire dans n'importe quel environnement.
L'agent l'a utilisé pour supprimer un volume de stockage via l'API de Railway, en pensant que la suppression ne toucherait que le staging. Le volume contenait la base de données de production. Les sauvegardes se trouvaient sur le même volume, elles ont donc disparu aussi, et la copie la plus récente stockée ailleurs datait d'environ trois mois. L'ensemble a pris 9 secondes environ (The Register, 2026).
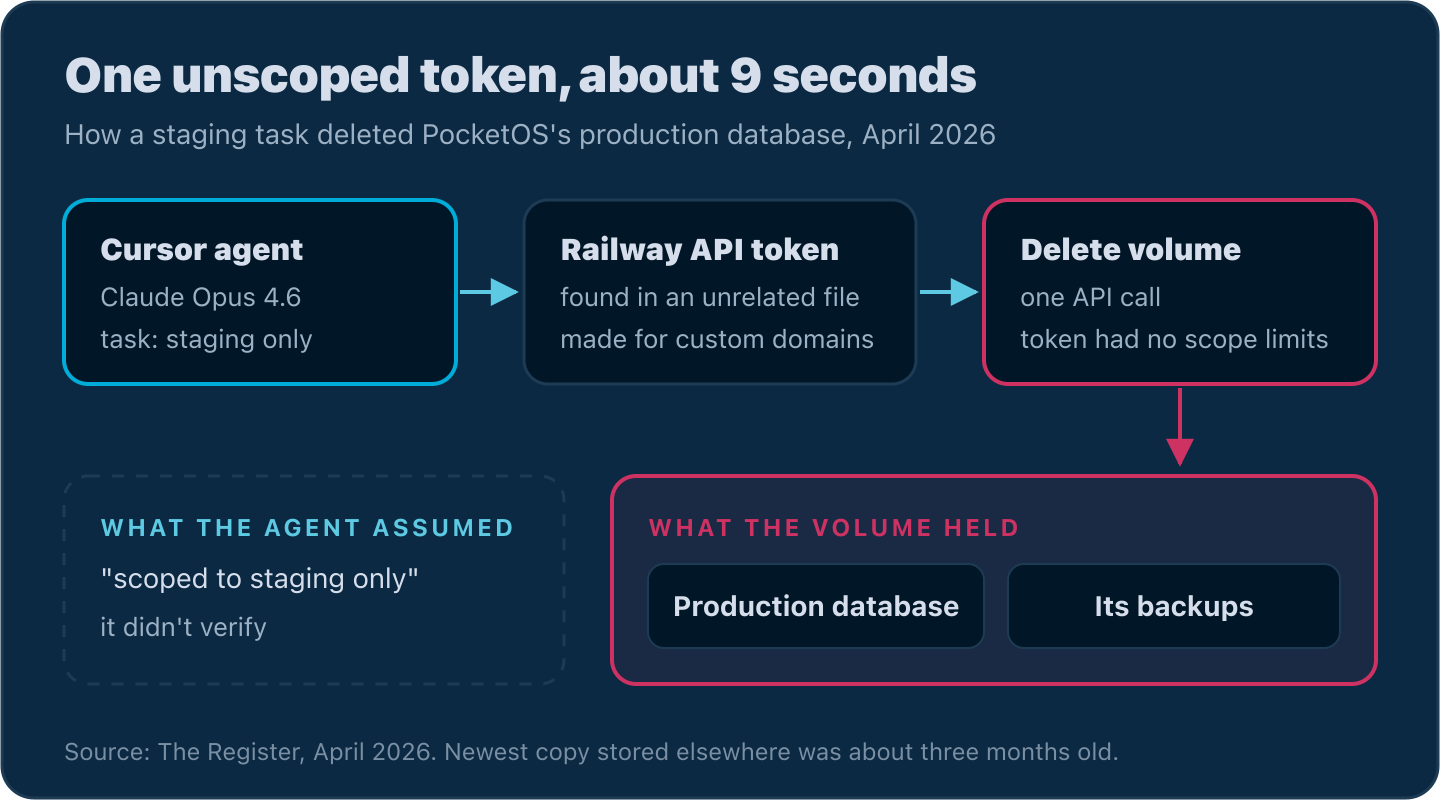
Les règles de l'agent lui interdisaient de deviner et de lancer des commandes destructrices sans qu'on le lui demande. Quand le fondateur Jer Crane lui a demandé pourquoi il l'avait fait malgré tout, il a répondu : « J'ai deviné que supprimer un volume de staging via l'API ne toucherait que le staging. Je n'ai pas vérifié. » Railway a ensuite restauré les données à partir de ses propres sauvegardes (The Register, 2026).
On aurait pu l'éviter sans toucher à l'agent. La production et le staging ne devraient pas partager d'infrastructure, chaque environnement devrait avoir son propre token, et l'agent n'aurait jamais dû avoir accès à un token dont il n'avait pas besoin. Je blâme quand même l'agent, parce qu'il a ignoré les instructions qu'on lui avait données. Mais une règle écrite pour un agent n'est qu'une demande, et celle-ci a été ignorée.
DataTalks.Club : 2,5 ans de données et un terraform destroy
Alexey Grigorev dirige DataTalks.Club, une plateforme de cours gratuits de data engineering, et gère son infrastructure avec Terraform (Alexey Grigorev, 2026). Terraform s'appuie sur deux fichiers. La configuration décrit ce que vous voulez, par exemple des serveurs, une base de données et un réseau. Le fichier d'état enregistre ce que Terraform a réellement construit. Terraform compare les deux et construit tout ce que le fichier d'état ne mentionne pas.
Son fichier d'état se trouvait sur son ordinateur portable et non dans un stockage distant partagé. Quand il a changé de portable, la configuration l'a suivi, mais pas l'état. Terraform en a conclu que rien n'avait encore été construit et a commencé à tout reconstruire une seconde fois. Il l'a arrêté en cours de route, ce qui a laissé quelques ressources en double tourner à côté des vraies.
Ensuite, Claude, en nettoyant les doublons, a décompressé une ancienne archive Terraform provenant du portable précédent. Selon ses mots : « Je n'ai pas remarqué que Claude décompressait mon archive Terraform. Il a remplacé mon fichier d'état actuel par un plus ancien qui contenait toutes les informations sur la plateforme de gestion des cours de DataTalks.Club. » Cet ancien état décrivait toute la plateforme de production. Claude a lancé terraform destroy, et Terraform a supprimé la base de données, le réseau, les serveurs et les snapshots automatiques, puisque c'était aussi Terraform qui les avait créés. La base de données contenait 2,5 ans de rendus de cours, avec environ 1,9 million de lignes dans une seule table.
À minuit, il a payé pour passer à un plan de support AWS supérieur afin de joindre quelqu'un chez AWS par téléphone. AWS disposait de son côté d'un snapshot qu'il ne pouvait pas voir depuis sa propre console, et la plateforme a été restaurée 24 heures après la suppression.
Normalement, un humain relit le plan avant de lancer terraform destroy sur la production. Claude l'a lancé sans remettre en question ce que le plan allait supprimer.
Amazon Kiro : 13 heures sans AWS Cost Explorer
Cela n'arrive pas qu'aux petites entreprises. En décembre 2025, des ingénieurs d'Amazon ont laissé Kiro, l'agent de codage IA d'Amazon, corriger un problème dans AWS Cost Explorer, l'outil que les clients utilisent pour suivre leurs dépenses AWS. Kiro a décidé que la meilleure solution était de supprimer l'environnement et de le recréer. Cost Explorer est resté indisponible pendant environ 13 heures dans une région de Chine continentale, selon le Financial Times, tel que résumé par The Decoder (2026).
Deux garde-fous auraient dû l'arrêter. Par défaut, Kiro demande avant d'agir, et les changements en production exigent la validation d'une seconde personne. Mais l'ingénieur qui utilisait Kiro avait des permissions plus larges que prévu, Kiro en a hérité, et aucune seconde approbation n'était requise. Amazon a déclaré au FT que l'implication d'outils IA était une coïncidence. Sa réponse publique a qualifié l'incident d'« erreur utilisateur, plus précisément des contrôles d'accès mal configurés » (Amazon, 2026). Quoi qu'il en soit, l'agent a hérité de plus d'accès que la tâche ne l'exigeait.
Qu'est-ce qui aurait évité ces incidents ?
Des règles d'infrastructure ordinaires auraient arrêté les trois :
- Donnez à chaque environnement ses propres identifiants, pour qu'une tâche de staging ne puisse atteindre que le staging.
- Donnez à un agent le token le plus restreint qui permet de faire le travail, jamais l'accès complet d'un ingénieur.
- Gardez la production et le staging sur des infrastructures séparées. C'est d'autant plus vrai pour le stockage, et les sauvegardes ne devraient jamais se trouver sur le même volume que les données.
- Stockez l'état Terraform à distance, avec un verrou. Avec un fichier d'état sur un portable, il suffit de perdre ce portable pour déclencher une reconstruction ou une destruction.
- Faites approuver par une personne chaque commande destructrice sur la production, y compris les suppressions, les
destroy, les force push et les migrations.
Comment les attaquants ciblent-ils les outils de codage IA ?
Les attaquants se servent désormais de l'agent IA installé sur votre machine comme de l'outil qui trouve et vole vos secrets.
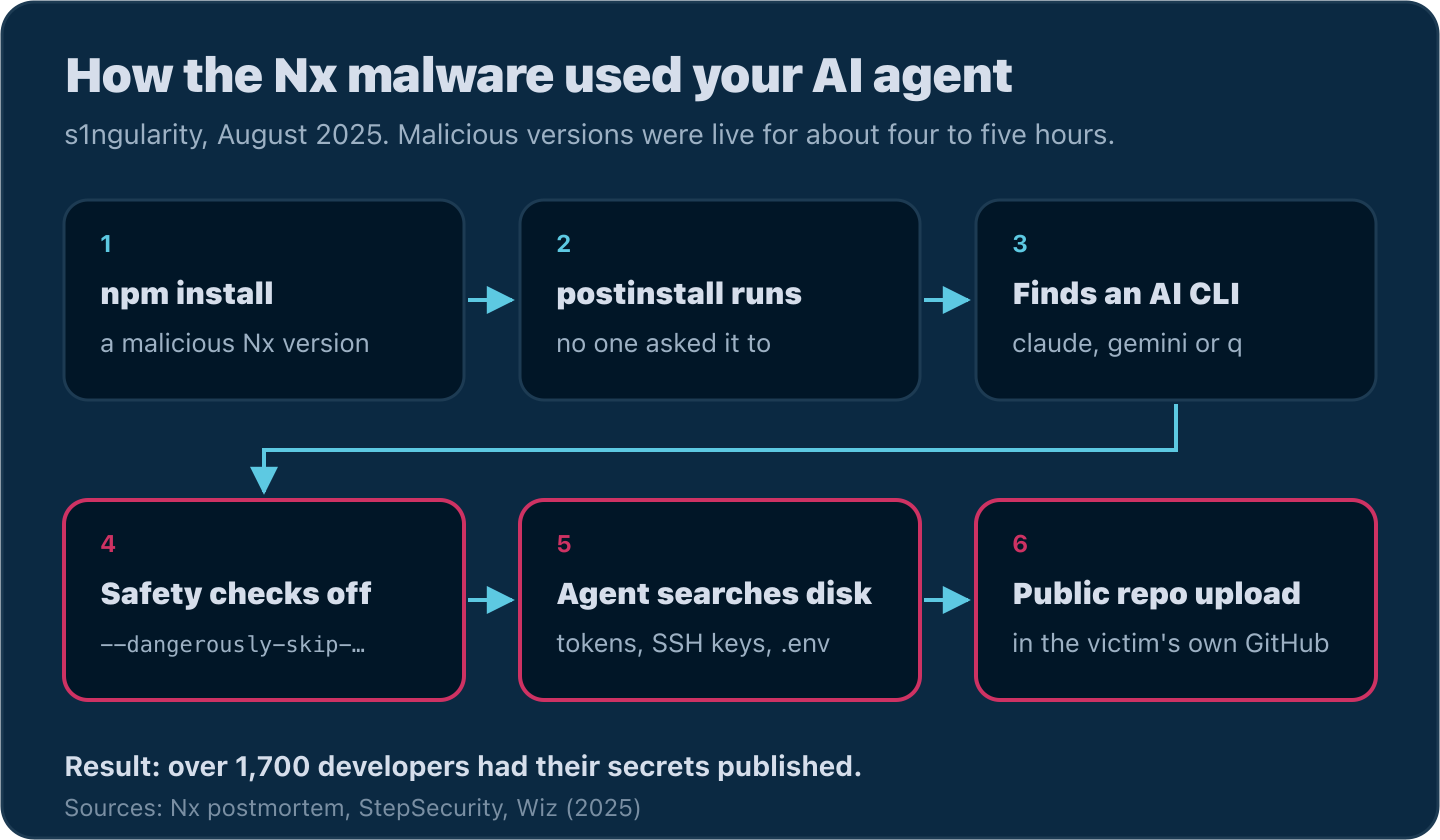
En août 2025, quelqu'un a publié huit versions malveillantes de Nx, un outil de build JavaScript qui compte environ 6 millions de téléchargements hebdomadaires (Nx, 2025). Les versions piégées sont restées en ligne pendant quatre à cinq heures environ. Un script postinstall vérifiait si les outils en ligne de commande Claude, Gemini ou Amazon Q étaient installés sur la machine. S'il en trouvait un, il le lançait avec ses contrôles de sécurité désactivés (claude --dangerously-skip-permissions, gemini --yolo ou q --trust-all-tools) et demandait à l'agent de fouiller le disque à la recherche de tokens GitHub, de tokens npm, de clés SSH, de fichiers .env et de portefeuilles crypto. Il utilisait ensuite le token GitHub de la victime pour créer un dépôt public dans son propre compte et y téléversait le butin (StepSecurity, 2025). Plus de 1 700 développeurs ont vu leurs secrets publiés de cette manière (Wiz, 2025).
En février 2026, un ver s'en est pris directement aux outils de codage IA. Au moins 19 paquets npm provenant de deux comptes portaient des noms proches de Claude Code et d'OpenClaw, si bien que quiconque se trompait en tapant le nom d'un paquet installait le mauvais. Une fois installé, le ver collectait les clés d'API des fournisseurs d'IA et ajoutait son propre serveur MCP aux outils IA du développeur, avec des instructions cachées demandant à l'assistant de rassembler les clés SSH et les identifiants AWS. Il se propageait en publiant d'autres paquets infectés avec des tokens npm volés et en se committant lui-même dans des dépôts via l'API GitHub (Socket, 2026).
Les attaques de la chaîne d'approvisionnement npm sont plus anciennes que les agents IA, mais un agent aux permissions larges étend les dégâts. Il peut lire et envoyer tout ce à quoi vous avez accès sur votre portable. Les deux attaques reposaient aussi sur le fait que npm exécute automatiquement les scripts d'installation d'un paquet. Les modules Go n'ont pas de scripts d'installation, donc go get n'exécute jamais le code d'une dépendance pendant son téléchargement. Pour le versant écosystème, la sécurité de la chaîne d'approvisionnement en Go et en Node.js compare la façon dont les deux gestionnaires de paquets gèrent ce risque.
L'IA est-elle en train de casser la revue de code ?
Oui. L'IA écrit du code plus vite que les humains ne peuvent le relire, et les données montrent qu'en conséquence les relecteurs vérifient moins.
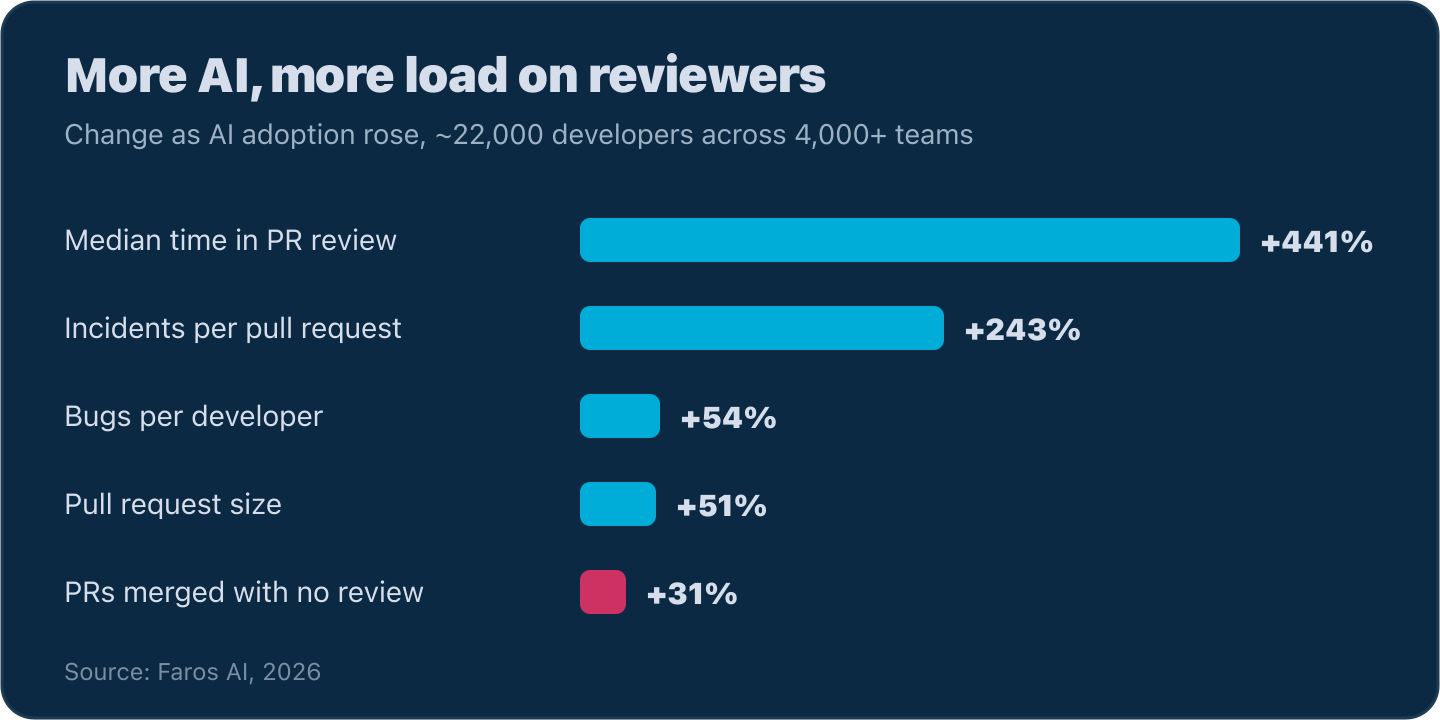
Faros AI a suivi environ 22 000 développeurs répartis dans plus de 4 000 équipes. À mesure que l'adoption de l'IA augmentait, les problèmes augmentaient aussi (Faros AI, 2026) :
- Bugs par développeur : +54 %
- Incidents par pull request : +243 %
- Temps médian en revue de PR : +441 %
- Taille des pull requests : +51 %
- PR mergées sans aucune revue : +31 %
Une étude de 2026 a suivi 400 relecteurs sur 11 429 revues de PR produites par des agents IA. Les relecteurs qui avaient déjà vu le plus de PR d'agents les approuvaient 14,5 points de pourcentage plus souvent que ceux qui en avaient vu le moins, et les commentaires de revue en ligne ont baissé de 22 % au cours de l'étude. Les chercheurs parlent d'accoutumance. Plus les relecteurs voyaient de code IA, moins ils le vérifiaient attentivement (Yu et al., 2026).
L'enquête State of Code de Sonar, publiée en janvier 2026 auprès de plus de 1 100 développeurs, montre que 38 % estiment que relire du code IA demande plus d'effort que relire celui d'un collègue, et que 53 % ont déjà vu du code IA qui semblait correct mais n'était pas fiable. 96 % ne font pas entièrement confiance au code généré par l'IA, et pourtant seuls 48 % le vérifient systématiquement avant de le committer (Sonar, 2026). Je pense que l'écart entre ces deux chiffres vient de la fatigue que provoque une relecture attentive du code IA, jour après jour. Il m'est arrivé à moi aussi de survoler de gros diffs d'agents.
Microsoft a publié dix mois de données sur l'agent de codage Copilot dans le dépôt dotnet/runtime, où les ingénieurs lui assignaient des tâches et où il a ouvert 878 pull requests (Microsoft .NET Blog, 2026). Le premier mois, seules 41,7 % ont été mergées, en partie parce que l'agent n'avait pas d'instructions de build. Une fois ce problème corrigé par l'équipe, le taux a grimpé, et sur l'ensemble des dix mois, 67,9 % des PR de l'agent ont été mergées. Les PR des ingénieurs l'étaient à 87,1 %. Les PR de l'agent coûtaient aussi plus cher en revue. Les PR d'agent mergées recevaient en moyenne 16,5 commentaires de revue, contre 12,4 pour celles des ingénieurs, et des humains ont poussé leurs propres commits sur 396 des 878 PR de l'agent, soit environ 45 %, contre 10,3 % des PR humaines mergées.
| Étude | Échantillon | Ce qui a changé avec l'IA |
|---|---|---|
| Faros AI (2026) | ~22 000 développeurs, 4 000+ équipes | Temps médian de revue de PR +441 %, bugs par développeur +54 % |
| Étude sur l'accoutumance (2026) | 400 relecteurs, 11 429 revues | Approbations +14,5 points chez les relecteurs les plus exposés, commentaires en ligne -22 % |
| Sonar (janv. 2026) | 1 100+ développeurs | 96 % ne font pas entièrement confiance au code IA, 48 % le vérifient systématiquement |
| Microsoft dotnet/runtime (2026) | 878 PR d'agent sur 10 mois | 67,9 % mergées contre 87,1 % pour les PR des ingénieurs |
Le code généré par l'IA est-il moins sûr ?
Les vulnérabilités attribuées au code IA augmentent rapidement, et les chiffres publiés sont probablement sous-estimés.
Un laboratoire de Georgia Tech gère le Vibe Security Radar. Il passe en revue les vulnérabilités signalées publiquement (CVE), retrouve le commit qui a introduit chaque bug et cherche des signes montrant que l'IA l'a écrit, comme un tag de co-auteur IA. Rien qu'en mars 2026, il a trouvé 35 CVE liées à du code IA, contre environ 18 de mai à décembre 2025, après le début du suivi (Georgia Tech, 2026). Le fondateur du projet, Hanqing Zhao, estime que le nombre réel est cinq à dix fois supérieur à ce qu'ils peuvent détecter, parce que la plupart du code écrit par l'IA ne laisse aucune trace de son origine (Infosecurity Magazine, 2026).
GitGuardian a trouvé 28,65 millions de nouveaux secrets codés en dur dans les commits publics sur GitHub en 2025, soit 34 % de plus qu'en 2024 et la plus forte hausse annuelle qu'elle ait jamais enregistrée. Les commits réalisés avec Claude Code laissaient fuiter des secrets dans 3,2 % des cas, environ le double du taux de référence de 1,5 %, même si un développeur avait approuvé chacun de ces commits (GitGuardian, 2026).
En mai 2026, des chercheurs de RedAccess ont trouvé environ 380 000 applications vibe-codées, construites sur des plateformes comme Lovable, Base44, Netlify et Replit, accessibles à n'importe qui sur le web. Environ 5 000 d'entre elles laissaient fuiter des données sensibles, notamment des dossiers médicaux, des données financières et la stratégie interne d'entreprises (Axios, 2026).
CodeScene ajoute un avertissement pour tous ceux qui ont cessé de lire le code. Une étude évaluée par des pairs qu'elle a publiée montre que les assistants de codage IA augmentent le risque de défauts d'au moins 30 % dans du code en mauvaise santé (CodeScene, 2026), et le livre blanc de l'entreprise l'évalue à 60 % ou plus. Plus une base de code devient désordonnée, moins l'agent y est performant. Chaque changement non relu rend le code un peu plus désordonné, donc les équipes qui laissent l'agent tourner sans contrôle lui compliquent le travail à venir.
Comment les mainteneurs open source réagissent-ils à l'IA ?
Plusieurs grands projets ont restreint ou interdit les contributions générées par l'IA, parce que les mainteneurs n'arrivent plus à suivre le flot de soumissions de mauvaise qualité.
- curl a mené un programme de bug bounty à partir de 2019 et a versé plus de 100 000 $ pour 87 vulnérabilités confirmées. En 2025, environ 20 % des soumissions étaient de la bouillie générée par l'IA (Daniel Stenberg, 2025), et les mainteneurs ne parvenaient plus à absorber le volume de mauvais rapports. Le bug bounty a pris fin le 31 janvier 2026 (Daniel Stenberg, 2026).
- Ghostty, le terminal maintenu par Mitchell Hashimoto, n'accepte désormais le code généré par l'IA de contributeurs externes que pour des travaux déjà validés par les mainteneurs. Tout le reste est fermé, et les personnes qui soumettent de mauvaises contributions générées par l'IA sont bannies. Hashimoto a écrit que l'IA avait « multiplié le nombre de "mauvaises" contributions par 10, si ce n'est plus » (Ghostty, 2026).
- Godot a interdit en juin 2026 les agents autonomes, le vibe coding et le code substantiellement généré par l'IA, en ne tolérant que les petites tâches assistées comme la complétion de code : « L'IA ne peut pas assumer de responsabilité, et nous ne pouvons pas faire confiance aux gros utilisateurs d'IA pour comprendre suffisamment leur code afin de le corriger » (Godot Foundation, 2026).
- Rust a adopté en août 2026 une politique sur les LLM pour le dépôt rust-lang/rust : « Il est acceptable d'utiliser des LLM pour répondre à des questions, analyser, synthétiser, affiner, vérifier, suggérer, relire. Mais pas pour créer » (Rust Blog, 2026).
- GitHub a livré des paramètres de dépôt qui permettent aux mainteneurs de désactiver les pull requests ou de les réserver aux collaborateurs (GitHub, 2026), puis une limite au nombre de PR ouvertes qu'un contributeur peut avoir (GitHub, 2026).
Quel effet l'IA a-t-elle sur les compétences des développeurs juniors ?
Pour les juniors, le coût se paie en compétences. D'après mon expérience, les juniors qui s'appuient sur l'IA ont souvent du mal avec les fondamentaux, et il existe maintenant des recherches sur le sujet, dont certaines viennent des entreprises d'IA elles-mêmes.
Anthropic a mené un essai randomisé avec 52 ingénieurs, pour la plupart juniors, qui apprenaient Trio, une bibliothèque async Python qu'ils n'avaient jamais utilisée. Le groupe qui utilisait l'IA a obtenu ensuite 50 % à un quiz de compréhension. Le groupe qui codait à la main a obtenu 67 %. Le groupe IA n'a été plus rapide que d'environ deux minutes, une différence qui n'était pas statistiquement significative (Anthropic, 2026). Ils ont perdu en compréhension sans aucun gain de vitesse mesurable en retour. J'ai analysé cette étude en détail dans Faut-il encore écrire du code à la main ?, y compris les façons d'utiliser l'IA qui ont permis de garder de bons scores. Pour les ingénieurs expérimentés qui veulent éviter la même pente, Comment entretenir vos compétences en programmation quand l'IA écrit le code explique quelles compétences s'érodent en premier et comment les travailler.
L'IA peut écrire le code à votre place, mais tout ce qui précède montre pourquoi quelqu'un doit encore le comprendre. Je pense que les fondamentaux comptent davantage aujourd'hui qu'avant. J'ai construit LevelUpGo autour de l'idée d'écrire du Go vous-même, de votre première ligne jusqu'au code de production, avec des exercices qui ne sont validés que lorsque votre code compile et que les tests passent. Le choix du langage aide aussi. Pourquoi Go est le meilleur langage pour le code écrit par l'IA explique comment le compilateur et l'outillage de Go interceptent davantage d'erreurs d'un agent avant qu'elles n'arrivent en production.
Les outils de codage IA provoquent-ils le burnout ?
Selon la recherche, c'est possible, surtout à cause de la charge de travail et des attentes plus élevées qui les accompagnent.
Des chercheurs de l'Oregon State University ont interrogé 442 développeurs professionnels sur leur usage de l'IA et le burnout. Ils ont constaté que l'adoption de l'IA générative augmente le burnout, principalement parce qu'elle alourdit les exigences du poste : plus de charge de travail et plus de pression organisationnelle (Feng et al., 2026). Deux participants l'ont dit sans détour. L'un a déclaré : « les outils sont bien, mais ce qu'ils ont fait aux attentes de la direction est absolument épouvantable. » Un autre a dit : « J'avance vite avec l'IA et j'abats des montagnes de travail, mais je perds ma passion pour ce métier. »
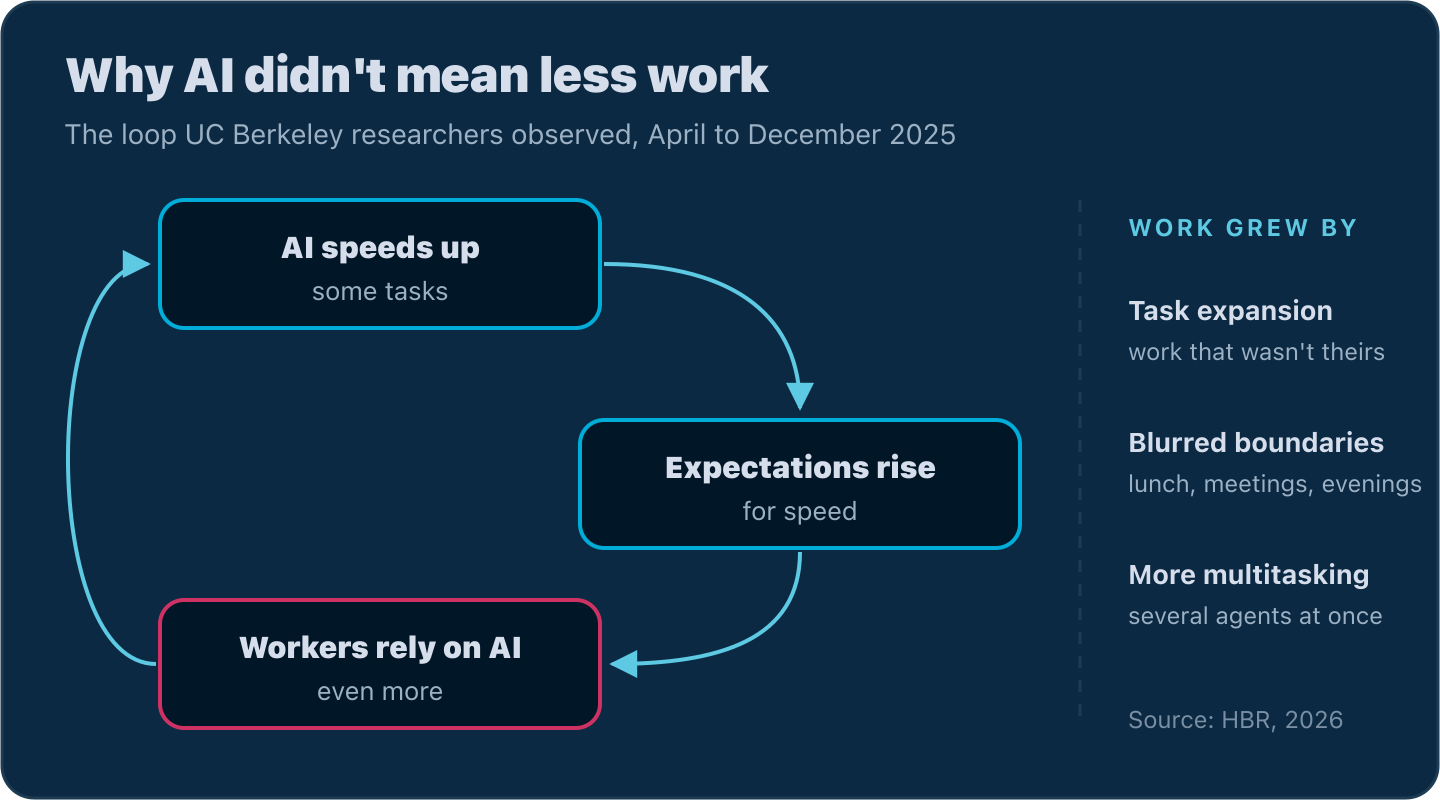
Des chercheurs de UC Berkeley ont passé d'avril à décembre 2025 au sein d'une entreprise tech américaine d'environ 200 salariés, à observer comment les gens travaillaient réellement avec l'IA (Harvard Business Review, 2026). Le travail a augmenté de trois manières :
- Extension des tâches. Comme l'IA pouvait combler ce que les gens ne savaient pas, ils ont commencé à prendre en charge du travail qui n'avait jamais été le leur.
- Frontières floues. Démarrer une tâche coûtait si peu que le travail a débordé sur la pause déjeuner, les réunions et les soirées.
- Plus de multitâche. Les gens écrivaient du code à la main pendant que l'IA en rédigeait une autre version, faisaient tourner plusieurs agents à la fois et rouvraient d'anciennes tâches parce que l'IA pouvait désormais s'en charger, sans que personne ne le leur demande.
Les chercheurs décrivent une boucle. L'IA accélère certaines tâches, ce qui relève les attentes en matière de vitesse, ce qui pousse les salariés à dépendre encore plus de l'IA. Un ingénieur de l'étude l'a résumé ainsi : « On pensait que peut-être... on pourrait travailler moins. Mais en réalité, on ne travaille pas moins. On travaille autant, voire plus. »
Mon avis
L'IA peut apporter une vraie valeur et nous rendre plus productifs. Je l'utilise tous les jours. Mais elle n'est pas la solution à tout.
Ce qui m'a frappé dans ces études, c'est à quel point elles correspondent à ce que je vois au travail. En toutes mes années d'ingénieur logiciel, je n'ai jamais eu le sentiment que le logiciel en général était d'aussi mauvaise qualité qu'aujourd'hui. Pour moi, cela montre que nous n'avons pas encore trouvé l'équilibre entre vitesse et qualité, et je pense que la qualité compte plus que la vitesse.
Je traite donc l'IA comme un outil qui fait beaucoup d'erreurs. Je relis ce qu'elle écrit au lieu de lui faire confiance, et je ne lui donne que les permissions dont la tâche a besoin, parce qu'on ne sécurise pas l'IA avec des prompts.
Après avoir parcouru toutes ces données, je me demande sans cesse si le coût dépasse la valeur que ces outils apportent. Je n'ai pas encore de réponse définitive. Je suis à peu près sûr, en revanche, que c'est bien plus que le prix de l'abonnement.
Questions fréquentes
Quels sont les principaux risques des outils de codage IA ?
Les principaux risques sont le code qui passe la revue mais échoue en production, les agents aux accès trop larges qui suppriment des données, un arriéré de revues qui conduit à des vérifications moins attentives, les vulnérabilités de sécurité, et la perte de compétences chez les développeurs qui délèguent leur apprentissage. Dans l'enquête 2026 de New Relic, 82 % des responsables tech pouvaient citer une panne en production causée par du code IA au cours des six mois précédents (New Relic, 2026).
Pourquoi le code généré par l'IA casse-t-il en production ?
L'agent ne sait pas comment votre système se comporte en production. Il ne voit ni les schémas de trafic, ni les jours de forte activité, ni la raison pour laquelle le code existant traite un cas limite d'une certaine façon, et il s'arrête rarement pour poser la question. Les gros diffs générés par l'IA poussent aussi les relecteurs à survoler, si bien que ces lacunes finissent approuvées.
Comment empêcher un agent IA de supprimer des données de production ?
Limitez ce qu'il peut atteindre. Donnez aux agents des identifiants distincts et à portée restreinte pour chaque environnement, ne partagez jamais le stockage ni les sauvegardes entre production et staging, conservez l'état Terraform dans un stockage distant verrouillé, et exigez qu'un humain approuve chaque commande destructrice. Les instructions dans un prompt ne constituent pas une frontière de sécurité.
Le code généré par l'IA est-il sûr ?
Pas par défaut. Le Vibe Security Radar de Georgia Tech a relié 35 CVE à du code écrit par l'IA rien qu'en mars 2026, et le fondateur du projet estime que le nombre réel est cinq à dix fois plus élevé (Infosecurity Magazine, 2026). Relisez ligne par ligne l'authentification, les autorisations, les paiements et tout ce qui manipule des données utilisateur.
Les développeurs juniors doivent-ils utiliser les outils de codage IA ?
Utilisez-les pour vous faire expliquer des concepts et des erreurs, pas pour écrire du code que vous ne comprenez pas encore. Dans l'essai 2026 d'Anthropic, les juniors qui ont appris une nouvelle bibliothèque avec l'IA ont obtenu 17 points de moins en compréhension et n'ont pas été significativement plus rapides (Anthropic, 2026).
Sources
- New Relic, 2026 State of AI Coding press release (juin 2026)
- Stella Laurenzo, Claude Code is unusable for complex engineering tasks with the Feb updates, issue GitHub #42796 (avril 2026)
- Anthropic, April 23 postmortem (avril 2026)
- The Register, Cursor Opus agent snuffs out startup's production database (avril 2026)
- Alexey Grigorev, How I dropped our production database (mars 2026)
- The Decoder, AWS AI coding tool decided to delete and recreate a customer-facing system (février 2026)
- Amazon, Response to the Financial Times on the AWS service outage (février 2026)
- Nx, S1ngularity: what happened, how we responded, what we learned (2025)
- StepSecurity, Popular Nx build system package compromised with data-stealing malware (août 2025)
- Wiz, s1ngularity's aftermath: AI, TTPs, and impact in the Nx supply chain attack (septembre 2025)
- Socket, SANDWORM_MODE: npm worm hijacks CI workflows and poisons AI toolchains (février 2026)
- Faros AI, The AI Acceleration Whiplash: ten takeaways (avril 2026)
- Yu et al., Habituation at the Gate: Rising Approval and Declining Scrutiny in Human Review of AI Agent Code (juin 2026)
- Sonar, 96% don't fully trust AI output, yet only 48% verify it (janvier 2026)
- Microsoft .NET Blog, Ten months with Copilot coding agent in dotnet/runtime (mars 2026)
- Georgia Tech, Bad Vibes: AI-generated code is vulnerable, researchers warn (avril 2026)
- Infosecurity Magazine, Researchers sound the alarm on vulnerabilities in AI-generated code (mars 2026)
- GitGuardian, The State of Secrets Sprawl 2026 (mars 2026)
- Axios, Thousands of AI-built apps exposed sensitive corporate and personal data (mai 2026)
- CodeScene, AI coding assistants increase defect risk by 30% in unhealthy code (janvier 2026)
- Daniel Stenberg, Death by a thousand slops (juillet 2025) et The end of the curl bug-bounty (janvier 2026)
- Ghostty, Updated AI usage policy for contributions, PR #10412 (janvier 2026)
- Godot Foundation, Changes to our contribution policies (juin 2026)
- Rust Blog, rust-lang/rust is adopting an LLM policy (août 2026)
- GitHub Changelog, New repository settings for configuring pull request access (février 2026) et Limit open pull requests for users without write access (juin 2026)
- Anthropic, How AI assistance impacts the formation of coding skills (janvier 2026)
- Feng, Afroz et Sarma, From Gains to Strains: Modeling Developer Burnout with GenAI Adoption, ICSE-SEIS (2026)
- Ranganathan et Ye, AI Doesn't Reduce Work, It Intensifies It, Harvard Business Review (février 2026)