
الاشتراك هو أرخص جزء في أداة البرمجة بالذكاء الاصطناعي. سواء دفعت $20 أو $100 أو $200 شهريًا، فإن التكاليف الأكبر لا تظهر في الفاتورة. إنها تظهر لاحقًا في صورة كود يجتاز المراجعة ثم يتعطل في بيئة الإنتاج، وتطبيقات تسرّب بيانات مستخدميها، وكود أكثر مما يستطيع أي أحد مراجعته، ووكلاء لديهم صلاحيات أوسع من اللازم يحذفون قواعد بيانات الإنتاج، ومهندسين يصابون بالاحتراق الوظيفي.
أعمل مهندس برمجيات في شركة تقنية كبرى، وأستخدم هذه الأدوات كل يوم. لست من كارهي الذكاء الاصطناعي. لكنني واجهت بنفسي كثيرًا من المشكلات الواردة في هذا المقال، وفي 2026 صار هناك أخيرًا ما يكفي من البيانات للتعبير عنها بالأرقام.
الخلاصة
- كود الذكاء الاصطناعي يبدو في المراجعة أفضل مما يتصرف في بيئة الإنتاج. في استطلاع New Relic الصادر في يونيو 2026، الذي شمل 200 من قادة التقنية في الولايات المتحدة، قيّم 94% كود الذكاء الاصطناعي عند المراجعة بأنه أعلى جودة من الكود الذي يكتبه البشر. واستطاع 82% أن يشيروا إلى عطل في بيئة الإنتاج سببه كود الذكاء الاصطناعي خلال الأشهر الستة السابقة (New Relic, 2026).
- الوكلاء ذوو الصلاحيات الواسعة يدمرون الأشياء بسرعة. حذف وكيل في Cursor يعمل بـ Claude قاعدة بيانات الإنتاج الخاصة بـ PocketOS في نحو 9 ثوانٍ، ومسح أمر
terraform destroyنفّذه Claude بيانات دورات DataTalks.Club المتراكمة على مدى 2.5 سنة. في الحالتين، كانت الصلاحيات المحددة النطاق ستوقف الوكيل حيث لم تفلح تعليماته. - المراجعة هي عنق الزجاجة الجديد. مع ارتفاع اعتماد الذكاء الاصطناعي لدى نحو 22,000 مطور، ارتفع الوقت الوسيط الذي يقضيه طلب الدمج (PR) في المراجعة بنسبة 441%، وارتفع عدد الأخطاء لكل مطور بنسبة 54% (Faros AI, 2026).
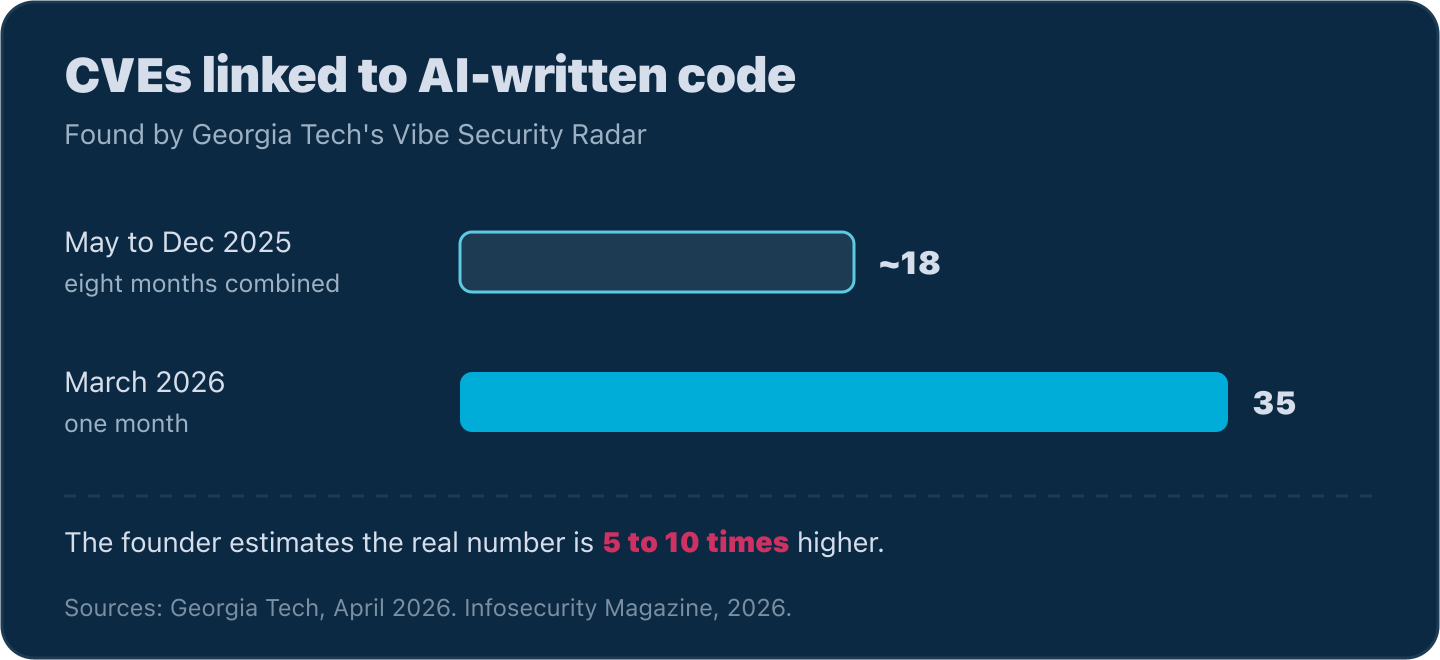
- الثغرات الأمنية في ازدياد. ربط باحثون في Georgia Tech عدد 35 ثغرة CVE بكود كتبه الذكاء الاصطناعي في مارس 2026 وحده، مقابل نحو 18 ثغرة من مايو إلى ديسمبر 2025 (Georgia Tech, 2026).
- والبشر يدفعون الثمن أيضًا. حصل المبتدئون الذين تعلموا بمساعدة الذكاء الاصطناعي على 50% في اختبار فهم، مقابل 67% لمن كتبوا الكود يدويًا (Anthropic, 2026). ووجد استطلاع شمل 442 مطورًا أن اعتماد الذكاء الاصطناعي يزيد الاحتراق الوظيفي عبر رفع متطلبات العمل (Feng et al., 2026).
لماذا يجتاز كود الذكاء الاصطناعي المراجعة ثم يتعطل في بيئة الإنتاج؟
يجتاز كود الذكاء الاصطناعي المراجعة لأنه يبدو نظيفًا. ويتعطل في بيئة الإنتاج لأن الوكيل الذي كتبه لا يعرف كيف يتصرف نظامك تحت حركة المرور الحقيقية، ولا يعرف لماذا كُتب الكود الموجود بالطريقة التي كُتب بها.
في يونيو 2026 نشرت New Relic استطلاعها State of AI Coding الذي شمل 200 من قادة التقنية في الولايات المتحدة (New Relic, 2026). في مرحلة المراجعة، قيّم 94% الكود المولَّد بالذكاء الاصطناعي بأنه أعلى جودة من الكود الذي يكتبه البشر، وقال 33% إنه أعلى جودة بكثير. وبعد أن وصل هذا الكود إلى بيئة الإنتاج، انقلبت الإجابات:
- أفاد 78% بزيادة حوادث الإنتاج خلال الأشهر الـ 12 الماضية
- قال 86% إن المهندسين الأوائل يقضون وقتًا أطول في إصلاح الكود
- قال 74% إن ربع الكود المولَّد بالذكاء الاصطناعي لديهم على الأقل احتاج إلى إعادة عمل كبيرة
- استطاع 82% أن يشيروا إلى عطل في بيئة الإنتاج خلال الأشهر الستة الماضية سببه كود الذكاء الاصطناعي
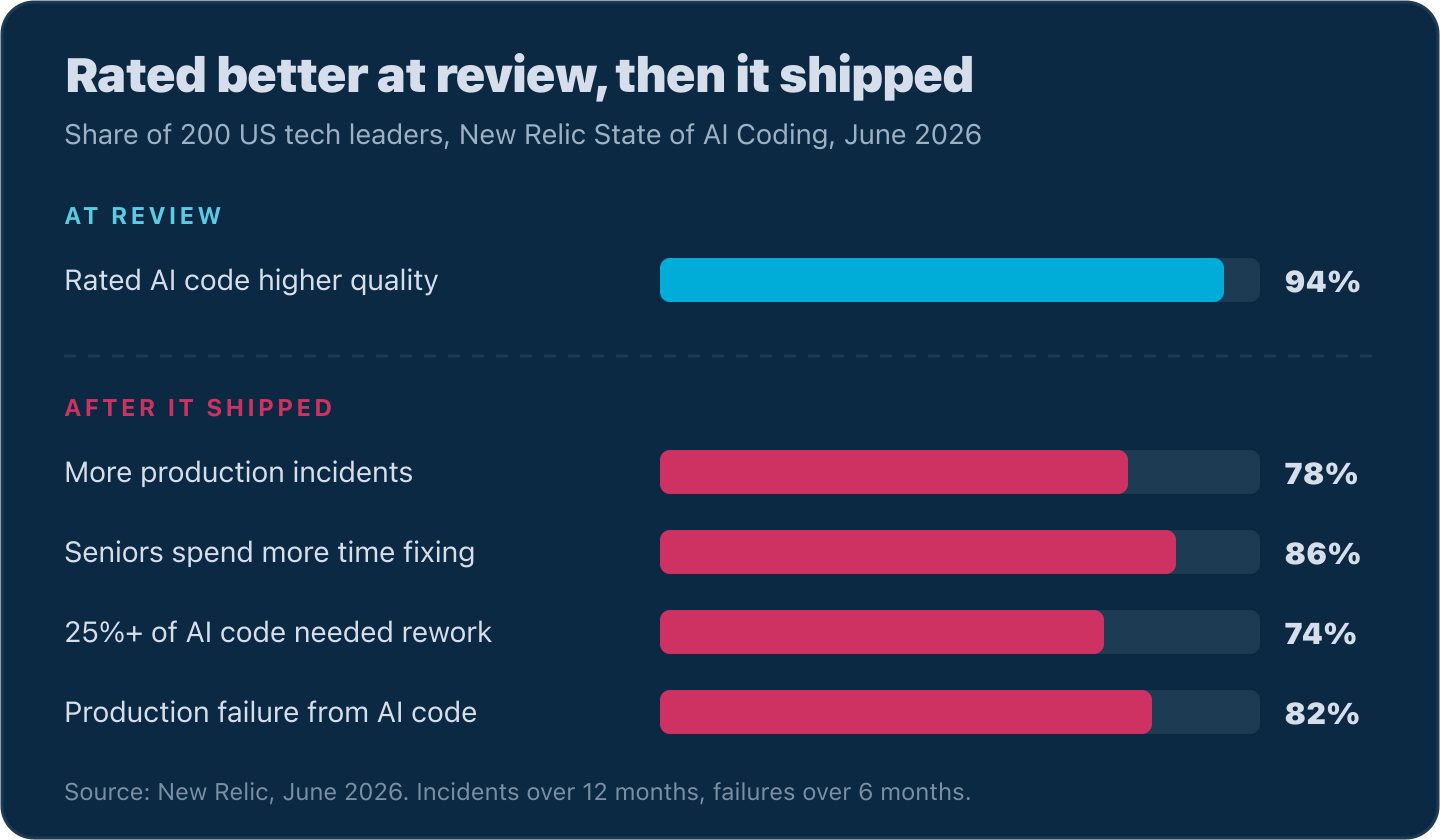
إذا كان الكود أفضل عند المراجعة، فلماذا يستمر في التعطل؟ أرى في عملي أربعة أسباب.
الوكيل لا يعرف النظام. لا يستطيع أن يرى حجم حركة المرور التي تتعامل معها الخدمة، ولا الأيام التي يشتد فيها الضغط، ولا أي تبعية لاحقة (downstream) تنهار أولًا. لا شيء من ذلك موجود في الـ diff.
لا يعرف لماذا كُتب الكود بهذه الطريقة. في كل قاعدة كود ناضجة شروط غريبة. ربما يحتوي مسار الدفع على فحص غير مألوف لأن مطورًا سابقًا اصطدم بخطأ لدى مزوّد الخدمة فالتفّ عليه. الإنسان الذي يقرأ هذا الكود سيسأل من كتبه. أما الوكيل فلا يسأل. إنه يخمّن ويمضي قدمًا، وكثيرًا ما يخطئ تخمينه.
المراجعون يفقدون انتباههم أمام الـ diffs الكبيرة. عندما ينتج الوكيل مئات الأسطر دفعة واحدة، يشعر المراجع بأنه غارق فيها. وبعد فترة تتوقف عن القراءة بتمعن، ويُعتمد الكود لأنه يبدو سليمًا. والحالات الحدية التي سيتعامل معها دون تفكير مهندس عمل في هذا الكود لسنوات هي بالضبط الحالات التي لا يتحقق منها أحد.
ديون الوكلاء تتراكم. وهي كود ذكاء اصطناعي رديء يصل إلى بيئة الإنتاج ولا يُنظَّف أبدًا. وكأي دين تقني، يكبر مع الوقت، وفي النهاية يتحول إلى حادثة في بيئة الإنتاج.
ماذا يحدث عندما تتراجع أداة الذكاء الاصطناعي نفسها؟
ينخفض إنتاج فريقك، ومن الصعب أن تلاحظ ذلك. في مارس وأبريل 2026 قضى المطورون أسابيع يشتكون من أن Claude Code صار أسوأ. حللت Stella Laurenzo، مديرة مجموعة الذكاء الاصطناعي في AMD، عدد 6,852 جلسة من Claude Code، ووجدت أن الوكيل صار يقرأ كودًا أقل بكثير قبل إجراء التعديلات. فقد انخفض من 6.6 قراءة ملف لكل تعديل إلى 2.0 (GitHub issue #42796, 2026).
أرجع تقرير ما بعد الحادثة (postmortem) الذي نشرته Anthropic هذا التراجع إلى ثلاثة تغييرات كانت قد أطلقتها، منها خطأ في التخزين المؤقت (caching) كان يمحو تفكير النموذج في كل دور. هذا الخطأ «تجاوز عدة مراجعات كود بشرية وآلية، إضافة إلى اختبارات الوحدة والاختبارات الشاملة (end-to-end) والتحقق الآلي والاستخدام الداخلي (dogfooding)» (Anthropic, 2026).
فكّر في ما يعنيه ذلك لشركة فيها مئات المهندسين الذين يعتمدون على هذه الأدوات. لأسابيع، يعمل قسم الهندسة كله بإنتاجية منخفضة، ولا يكاد أحد يلاحظ. فعندما يسيء الوكيل الأداء، تهز كتفيك وتقول لنفسك «إنه ذكاء اصطناعي، هذا يحدث أحيانًا».
تقول Anthropic إن شيئًا من هذا لم يكن متعمدًا، وأنا أصدقها. ومع ذلك أثار الأمر قلقي. عندما يعتمد فريقك على نموذج من Anthropic أو OpenAI أو أي جهة أخرى، فإن المزوّد هو من يقرر مدى جودة هذا النموذج اليوم. ولو قرر مزوّد يومًا أن يخفض الجودة، فإن المطورين الأكثر اعتمادًا على الأداة سيكونون الأشد تضررًا. وحفنة من الشركات باتت الآن تحدد جودة حصة كبيرة من الكود الجديد في العالم.
هل يمكن لوكيل ذكاء اصطناعي أن يحذف قاعدة بيانات الإنتاج لديك؟
نعم. حدث ذلك في ثلاث حالات على الأقل أُعلن عنها خلال العام الماضي، وفي كل مرة كانت لدى الوكيل صلاحيات تفوق بكثير ما تحتاجه مهمته.
PocketOS: بيئة الإنتاج تختفي في 9 ثوانٍ
في أبريل 2026 كان وكيل ذكاء اصطناعي في Cursor، يعمل بنموذج Claude Opus 4.6 من Anthropic، ينفذ مهمة في بيئة الاختبار (staging) لدى PocketOS، فواجه مشكلة في بيانات الاعتماد. فراح يبحث عن بيانات اعتماد، ووجد رمز API من Railway في ملف لا علاقة له بالمهمة. أُنشئ هذا الرمز لإدارة النطاقات المخصصة، لكنه لم يكن مقيدًا بأي نطاق صلاحيات. أي شخص يملكه كان يستطيع فعل أي شيء في أي بيئة.
استخدمه الوكيل لحذف وحدة تخزين (volume) عبر API الخاص بـ Railway، معتقدًا أن الحذف سيقتصر على بيئة الاختبار. لكن وحدة التخزين كانت تحتوي على قاعدة بيانات الإنتاج. وكانت النسخ الاحتياطية على وحدة التخزين نفسها، فذهبت هي أيضًا، وكان عمر أحدث نسخة محفوظة في أي مكان آخر نحو ثلاثة أشهر. استغرق الأمر كله نحو 9 ثوانٍ (The Register, 2026).
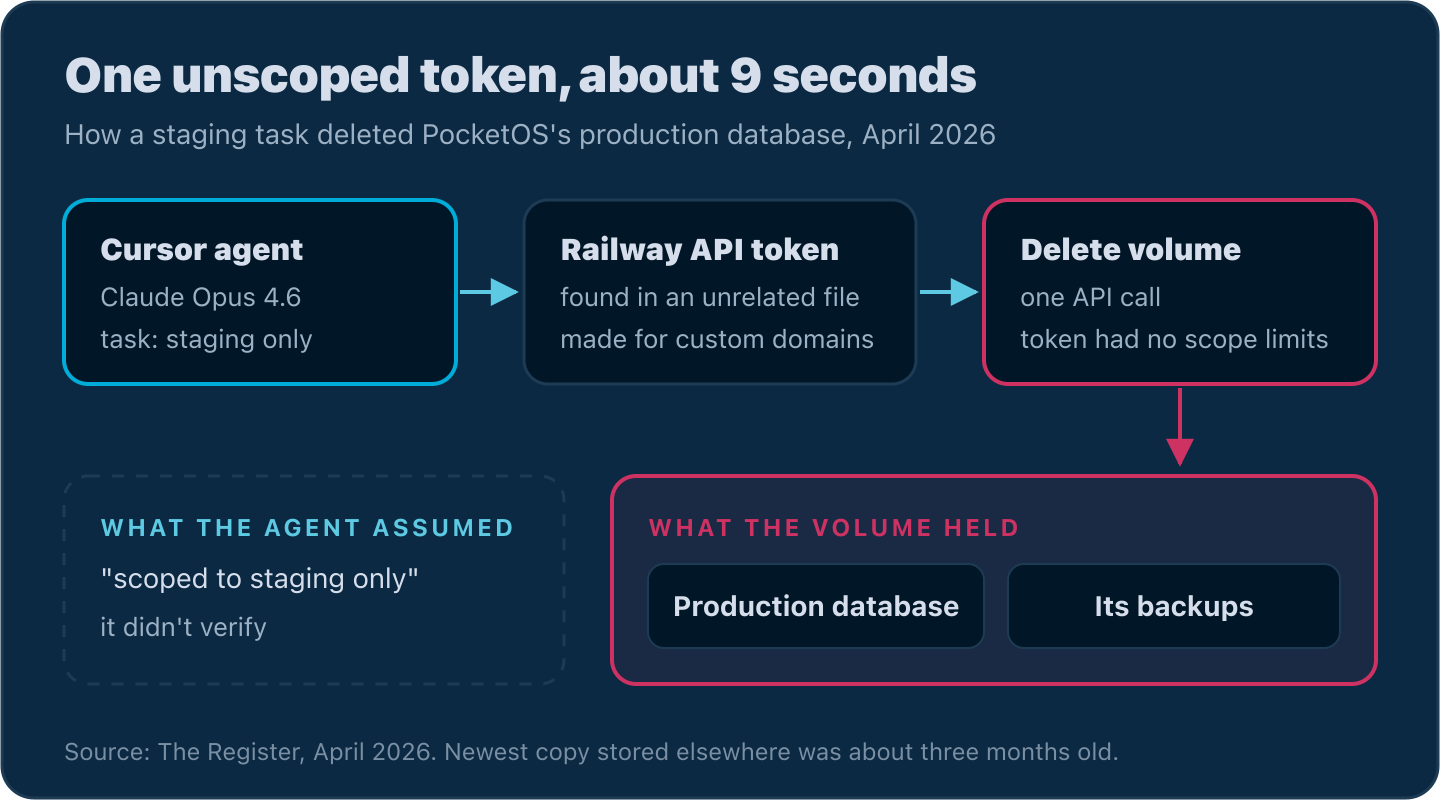
كانت قواعد الوكيل تنص على ألا يخمّن أبدًا، وألا ينفذ أوامر تدميرية أبدًا ما لم يُطلب منه ذلك. وعندما سأله المؤسس Jer Crane لماذا فعل ذلك رغم هذا، أجاب: «خمّنت أن حذف وحدة تخزين في بيئة الاختبار عبر API سيقتصر على بيئة الاختبار فقط. لم أتحقق.» واستعادت Railway البيانات لاحقًا من نسخها الاحتياطية الخاصة (The Register, 2026).
كان يمكن منع ذلك دون المساس بالوكيل. لا ينبغي أن تتشارك بيئتا الإنتاج والاختبار البنية التحتية، وينبغي أن يكون لكل بيئة رمزها الخاص، وما كان ينبغي أن يصل الوكيل أصلًا إلى رمز لا يحتاجه. ما زلت ألوم الوكيل، لأنه تجاهل تعليمات أُعطيت له. لكن القاعدة التي تكتبها لوكيل ليست سوى طلب، وهذا الطلب جرى تجاهله.
DataTalks.Club: بيانات 2.5 سنة وأمر terraform destroy واحد
يدير Alexey Grigorev منصة DataTalks.Club، وهي منصة لدورات مجانية في هندسة البيانات، ويدير بنيتها التحتية باستخدام Terraform (Alexey Grigorev, 2026). يعمل Terraform بملفين. ملف الإعدادات يصف ما تريده، مثل الخوادم وقاعدة البيانات والشبكة. وملف الحالة (state) يسجل ما بناه Terraform فعلًا. يقارن Terraform بين الملفين ويبني كل ما لا يرد في ملف الحالة.
كان ملف الحالة لديه محفوظًا على حاسوبه المحمول بدلًا من تخزين بعيد مشترك. وعندما انتقل إلى حاسوب آخر، انتقلت معه الإعدادات ولم تنتقل الحالة. فاستنتج Terraform أن شيئًا لم يُبنَ بعد، وبدأ يبني كل شيء مرة ثانية. أوقفه في منتصف الطريق، فبقيت بعض الموارد المكررة تعمل إلى جانب الموارد الحقيقية.
ثم فكّ Claude، أثناء تنظيف الموارد المكررة، أرشيفًا قديمًا لـ Terraform من الحاسوب السابق. يقول: «لم ألاحظ أن Claude يفك أرشيف Terraform الخاص بي. لقد استبدل ملف الحالة الحالي بملف أقدم كان يحتوي على كل المعلومات عن منصة إدارة دورات DataTalks.Club.» كانت تلك الحالة الأقدم تصف منصة الإنتاج بأكملها. نفّذ Claude الأمر terraform destroy، فحذف Terraform قاعدة البيانات والشبكة والخوادم واللقطات الآلية (snapshots)، لأن Terraform كان قد أنشأها هي أيضًا. كانت قاعدة البيانات تضم تسليمات الدورات على مدى 2.5 سنة، مع نحو 1.9 مليون صف في جدول واحد.
في منتصف الليل دفع مقابل ترقية خطة الدعم في AWS ليتمكن من التحدث هاتفيًا مع أحد موظفي AWS. كانت لدى AWS لقطة من جهتها لم يكن يستطيع رؤيتها من وحدة التحكم الخاصة به، واستُعيدت المنصة بعد 24 ساعة من الحذف.
عادةً يراجع إنسان الخطة قبل تنفيذ terraform destroy على بيئة الإنتاج. أما Claude فنفّذه دون أن يتساءل عما ستحذفه الخطة.
Amazon Kiro: توقف AWS Cost Explorer لمدة 13 ساعة
هذا لا يحدث للشركات الصغيرة وحدها. في ديسمبر 2025 سمح مهندسو Amazon لـ Kiro، وكيل البرمجة بالذكاء الاصطناعي الخاص بـ Amazon، بإصلاح مشكلة في AWS Cost Explorer، وهي الأداة التي يستخدمها العملاء لتتبع إنفاقهم على AWS. قرر Kiro أن أفضل حل هو حذف البيئة وإعادة إنشائها. وتوقف Cost Explorer نحو 13 ساعة في إحدى مناطق البر الرئيسي للصين، بحسب Financial Times، كما لخّصه موقع The Decoder (2026).
كان يُفترض أن توقفه ضمانتان. فـ Kiro يستأذن افتراضيًا قبل أن يتصرف، وتغييرات الإنتاج تحتاج إلى موافقة شخص ثانٍ. لكن المهندس الذي كان يشغّل Kiro كانت لديه صلاحيات أوسع من المتوقع، فورثها Kiro، ولم تكن هناك حاجة إلى موافقة ثانية. قالت Amazon لصحيفة FT إن تورط أدوات الذكاء الاصطناعي كان مصادفة. ووصف ردها العلني الحادثة بأنها «خطأ من المستخدم، وتحديدًا ضوابط وصول مُعدّة بشكل خاطئ» (Amazon, 2026). وأيًّا كان التفسير، فقد ورث الوكيل صلاحيات تفوق ما تحتاجه المهمة.
ما الذي كان سيمنع هذه الحوادث؟
كان يمكن إيقاف الحوادث الثلاث كلها بقواعد بنية تحتية عادية:
- امنح كل بيئة بيانات اعتماد خاصة بها، حتى لا تصل مهمة في بيئة الاختبار إلا إلى بيئة الاختبار.
- امنح الوكيل أضيق رمز يؤدي المهمة، ولا تمنحه أبدًا كامل صلاحيات مهندس.
- افصل البنية التحتية للإنتاج عن بيئة الاختبار، وخصوصًا التخزين. ولا تضع النسخ الاحتياطية أبدًا على وحدة التخزين نفسها التي تحمل البيانات.
- احفظ حالة Terraform في تخزين بعيد مقفل. ملف الحالة على حاسوب محمول لا يفصله عن إعادة بناء أو عن
destroyسوى ضياع ذلك الحاسوب. - اجعل شخصًا يوافق على كل أمر تدميري على بيئة الإنتاج، بما في ذلك عمليات الحذف و
destroyوالـ force push وعمليات الترحيل (migrations).
كيف يستهدف المهاجمون أدوات البرمجة بالذكاء الاصطناعي؟
صار المهاجمون الآن يستخدمون وكيل الذكاء الاصطناعي الموجود على جهازك أداةً للعثور على أسرارك وسرقتها.
في أغسطس 2025 نشر شخص ما ثماني نسخ خبيثة من Nx، وهي أداة بناء لـ JavaScript تُنزَّل نحو 6 ملايين مرة أسبوعيًا (Nx, 2025). بقيت النسخ الخبيثة متاحة لنحو أربع إلى خمس ساعات. كان سكربت postinstall يتحقق مما إذا كانت أدوات سطر الأوامر الخاصة بـ Claude أو Gemini أو Amazon Q مثبتة على الجهاز. فإن وجد إحداها، شغّلها مع تعطيل فحوص الأمان فيها (claude --dangerously-skip-permissions أو gemini --yolo أو q --trust-all-tools)، وطلب من الوكيل أن يبحث في القرص عن رموز GitHub ورموز npm ومفاتيح SSH وملفات .env ومحافظ العملات المشفرة. ثم استخدم رمز GitHub الخاص بالضحية لإنشاء مستودع عام في حسابه نفسه، ورفع المسروقات إليه (StepSecurity, 2025). ونُشرت أسرار أكثر من 1,700 مطور بهذه الطريقة (Wiz, 2025).
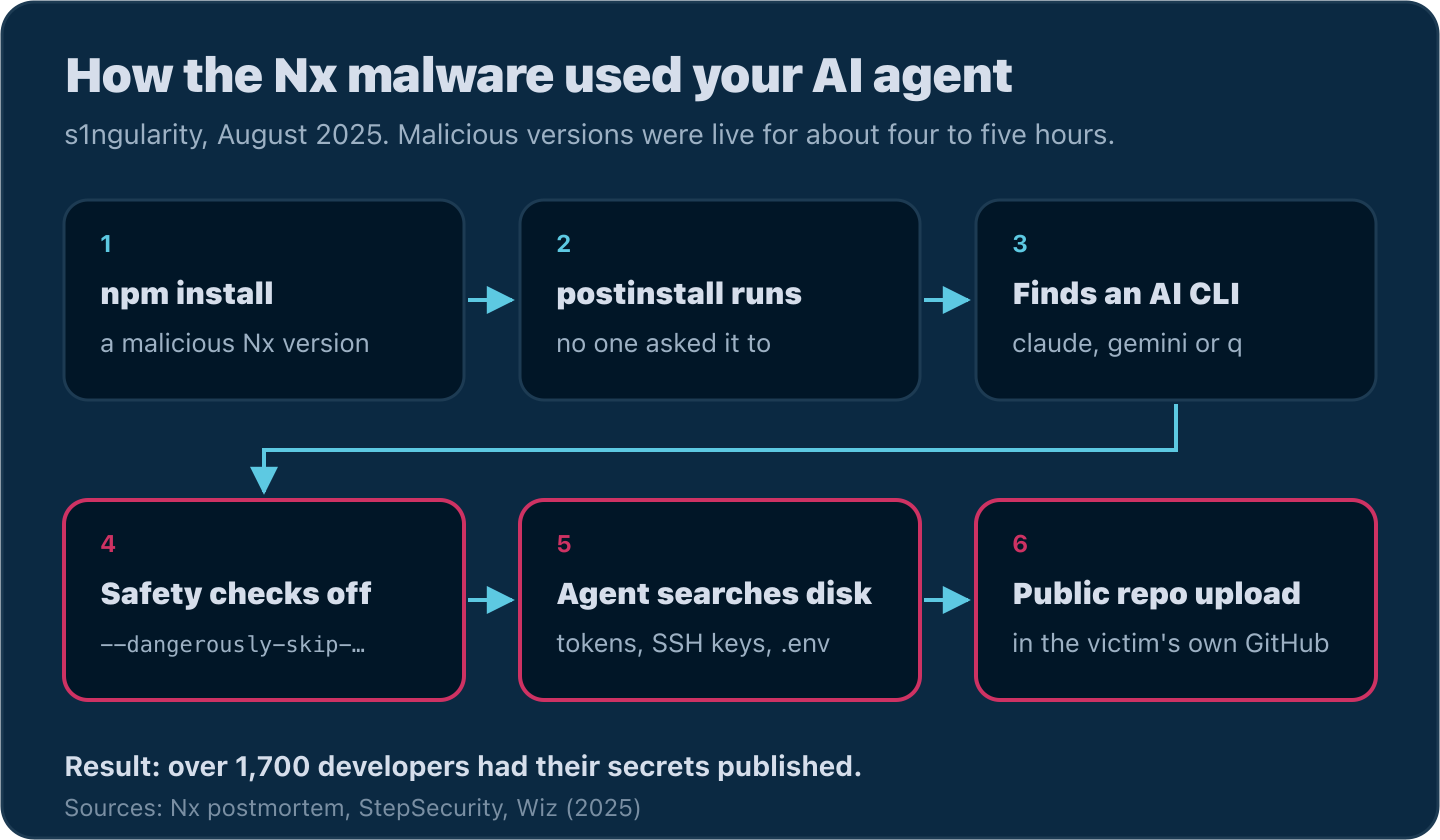
في فبراير 2026 استهدفت دودة (worm) أدوات البرمجة بالذكاء الاصطناعي مباشرة. استخدمت 19 حزمة npm على الأقل، صادرة عن حسابين، أسماء قريبة من Claude Code وOpenClaw، فكان كل من يخطئ في كتابة اسم الحزمة يثبّت الحزمة الخطأ. وبعد تثبيتها، كانت تجمع مفاتيح API الخاصة بمزوّدي الذكاء الاصطناعي، وتضيف خادم MCP خاصًا بها إلى أدوات الذكاء الاصطناعي لدى المطور، مع تعليمات مخفية تطلب من المساعد جمع مفاتيح SSH وبيانات اعتماد AWS. وكانت تنتشر بنشر مزيد من الحزم المصابة باستخدام رموز npm المسروقة، وبإيداع نفسها في المستودعات عبر GitHub API (Socket, 2026).
هجمات سلسلة التوريد عبر npm أقدم من وكلاء الذكاء الاصطناعي، لكن الوكيل ذا الصلاحيات الواسعة يوسّع الضرر. فهو يستطيع قراءة وإرسال كل ما تستطيع أنت الوصول إليه على حاسوبك. واعتمد الهجومان كلاهما أيضًا على أن npm يشغّل سكربتات التثبيت الخاصة بالحزمة تلقائيًا. أما وحدات Go فليست لها سكربتات تثبيت، لذلك لا يشغّل go get أبدًا كودًا من تبعية أثناء تنزيلها. وإذا أردت جانب المنظومة من هذا الموضوع، فمقال أمان سلسلة التوريد في Go مقابل Node.js يقارن كيف يتعامل مديرا الحزم مع هذه المسألة.
هل يُفسد الذكاء الاصطناعي مراجعة الكود؟
نعم. يكتب الذكاء الاصطناعي الكود أسرع مما يستطيع البشر مراجعته، وتُظهر البيانات أن المراجعين صاروا يتحققون أقل نتيجة لذلك.
تابعت Faros AI نحو 22,000 مطور في أكثر من 4,000 فريق. ومع ارتفاع اعتماد الذكاء الاصطناعي، ارتفعت المشكلات أيضًا (Faros AI, 2026):
- الأخطاء لكل مطور: +54%
- الحوادث لكل طلب دمج (pull request): +243%
- الوقت الوسيط في مراجعة الـ PR: +441%
- حجم طلب الدمج: +51%
- الـ PRs التي دُمجت دون أي مراجعة: +31%
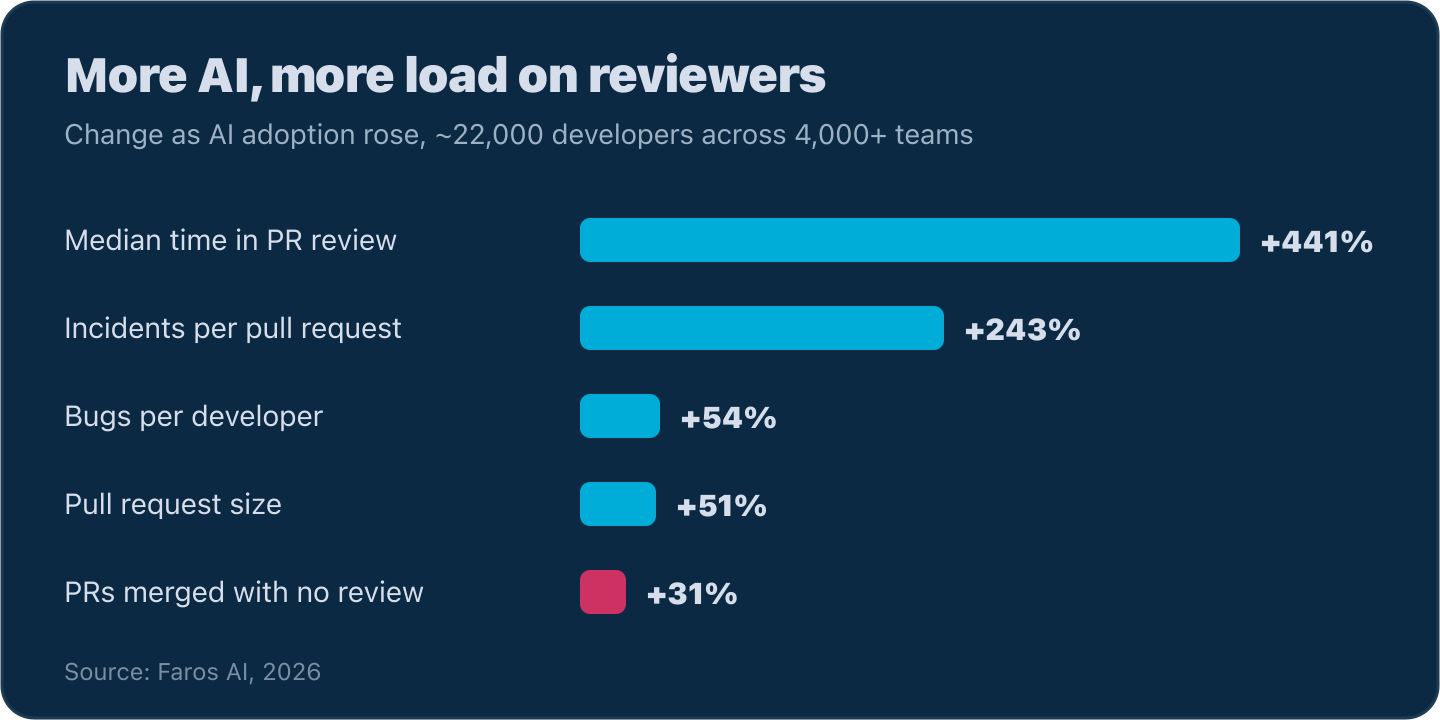
تابعت دراسة من 2026 عدد 400 مراجع عبر 11,429 مراجعة لطلبات دمج أنشأها وكلاء الذكاء الاصطناعي. المراجعون الذين كانوا قد رأوا أكبر عدد من طلبات دمج الوكلاء وافقوا عليها بنسبة تزيد 14.5 نقطة مئوية على من رأوا أقل عدد منها، وانخفضت تعليقات المراجعة المضمّنة (inline) بنسبة 22% خلال فترة الدراسة. يسمي الباحثون ذلك التعوّد (habituation). فكلما رأى المراجعون مزيدًا من كود الذكاء الاصطناعي، قلّ تدقيقهم فيه (Yu et al., 2026).
وجد استطلاع State of Code الذي أجرته Sonar في يناير 2026 وشمل أكثر من 1,100 مطور أن 38% يقولون إن مراجعة كود الذكاء الاصطناعي تتطلب جهدًا أكبر من مراجعة كود زميل، وأن 53% رأوا كودًا من الذكاء الاصطناعي بدا صحيحًا لكنه لم يكن موثوقًا. لا يثق 96% ثقة كاملة بالكود المولَّد بالذكاء الاصطناعي، ومع ذلك لا يتحقق منه دائمًا قبل الإيداع (commit) سوى 48% (Sonar, 2026). أظن أن الفجوة بين هذين الرقمين سببها مدى الإرهاق الذي تسببه مراجعة كود الذكاء الاصطناعي بعناية يومًا بعد يوم. وقد ضبطت نفسي أنا أيضًا أمرّ سريعًا على diffs كبيرة من الوكلاء دون تدقيق.
نشرت Microsoft بيانات عشرة أشهر عن وكيل البرمجة Copilot في مستودع dotnet/runtime، حيث كلّفه المهندسون بمهام وفتح 878 طلب دمج (Microsoft .NET Blog, 2026). في الشهر الأول لم يُدمج سوى 41.7% منها، ويعود ذلك جزئيًا إلى أن الوكيل كان يفتقر إلى تعليمات البناء. وبعد أن أصلح الفريق ذلك ارتفعت النسبة، وعلى مدى الأشهر العشرة كلها دُمج 67.9% من طلبات دمج الوكيل. أما طلبات الدمج التي أنشأها المهندسون أنفسهم فدُمج منها 87.1%. وتطلبت طلبات دمج الوكيل أيضًا مراجعة أكثر. فقد بلغ متوسط تعليقات المراجعة على طلبات الوكيل المدموجة 16.5 تعليقًا مقابل 12.4 لطلبات المهندسين، ودفع البشر إيداعاتهم الخاصة إلى 396 من طلبات الوكيل البالغة 878، أي نحو 45%، مقارنة بـ 10.3% من طلبات البشر المدموجة.
| الدراسة | العينة | ما الذي تغير مع الذكاء الاصطناعي |
|---|---|---|
| Faros AI (2026) | ~22,000 مطور، أكثر من 4,000 فريق | الوقت الوسيط لمراجعة الـ PR +441%، الأخطاء لكل مطور +54% |
| دراسة التعوّد (2026) | 400 مراجع، 11,429 مراجعة | الموافقات +14.5 نقطة لدى المراجعين الأكثر تعرضًا، التعليقات المضمّنة -22% |
| Sonar (يناير 2026) | أكثر من 1,100 مطور | 96% لا يثقون ثقة كاملة بكود الذكاء الاصطناعي، 48% يتحققون منه دائمًا |
| Microsoft dotnet/runtime (2026) | 878 طلب دمج من الوكيل خلال 10 أشهر | دُمج 67.9% مقابل 87.1% لطلبات المهندسين |
هل الكود المولَّد بالذكاء الاصطناعي أقل أمانًا؟
الثغرات التي تُنسب إلى كود الذكاء الاصطناعي تتزايد بسرعة، والأرقام المنشورة على الأرجح أقل من الواقع.
يدير مختبر في Georgia Tech مشروع Vibe Security Radar. يفحص المشروع الثغرات المعلنة (CVEs)، ويحدد الإيداع الذي أدخل كل خطأ، ويبحث عن علامات تدل على أن الذكاء الاصطناعي كتبه، مثل وسم مؤلف مشارك من الذكاء الاصطناعي. في مارس 2026 وحده وجد 35 ثغرة CVE مرتبطة بكود الذكاء الاصطناعي، مقابل نحو 18 من مايو إلى ديسمبر 2025 بعد بدء التتبع (Georgia Tech, 2026). ويقدّر مؤسس المشروع Hanqing Zhao أن العدد الحقيقي يبلغ خمسة إلى عشرة أضعاف ما يستطيعون رصده، لأن معظم الكود الذي يكتبه الذكاء الاصطناعي لا يترك أي أثر يدل على أنه جاء من الذكاء الاصطناعي (Infosecurity Magazine, 2026).
وجدت GitGuardian عدد 28.65 مليون سر جديد مكتوب مباشرة في الكود (hard-coded) في إيداعات GitHub العامة في 2025، بزيادة 34% عن 2024، وهي أكبر قفزة سنوية سجلتها على الإطلاق. وسرّبت الإيداعات التي أُنشئت باستخدام Claude Code أسرارًا بنسبة 3.2%، أي نحو ضعف خط الأساس البالغ 1.5%، مع أن مطورًا وافق على كل إيداع من تلك الإيداعات (GitGuardian, 2026).
في مايو 2026 وجد باحثون في RedAccess نحو 380,000 تطبيق مبني بأسلوب vibe coding على منصات مثل Lovable وBase44 وNetlify وReplit، كانت مفتوحة لأي شخص على الويب. ونحو 5,000 منها كانت تسرّب بيانات حساسة، منها سجلات طبية وبيانات مالية واستراتيجيات داخلية للشركات (Axios, 2026).
وتضيف CodeScene تحذيرًا لكل من توقف عن قراءة الكود. فقد وجدت دراسة محكّمة نشرتها أن مساعدي البرمجة بالذكاء الاصطناعي يرفعون خطر العيوب بنسبة 30% على الأقل في الكود غير السليم (CodeScene, 2026)، وتضع الورقة البيضاء الخاصة بالشركة النسبة عند 60% أو أكثر. كلما ازدادت قاعدة الكود فوضى، ساء أداء الوكيل فيها. وكل تغيير غير مراجَع يزيد الكود فوضى بعض الشيء، لذلك فإن الفرق التي تترك الوكيل يعمل دون رقابة تجعل عمله المستقبلي أصعب.
كيف يتعامل مشرفو المشاريع مفتوحة المصدر مع الذكاء الاصطناعي؟
قيّدت عدة مشاريع كبرى مساهمات الذكاء الاصطناعي أو حظرتها، لأن المشرفين لا يستطيعون مجاراة المساهمات الرديئة.
- curl أدار برنامج مكافآت للثغرات (bug bounty) منذ 2019، ودفع أكثر من $100,000 مقابل 87 ثغرة مؤكدة. في 2025 كانت نحو 20% من البلاغات محتوى رديئًا مولَّدًا بالذكاء الاصطناعي (AI slop) (Daniel Stenberg, 2025)، ولم يعد المشرفون قادرين على مجاراة حجم البلاغات السيئة. انتهى البرنامج في 31 يناير 2026 (Daniel Stenberg, 2026).
- Ghostty، الطرفية التي يشرف عليها Mitchell Hashimoto، صار يقبل الكود المولَّد بالذكاء الاصطناعي من المساهمين الخارجيين فقط في الأعمال التي وافق عليها المشرفون مسبقًا. وكل ما عدا ذلك يُغلق، ويُحظر من يقدّمون مساهمات رديئة بالذكاء الاصطناعي. وكتب Hashimoto أن الذكاء الاصطناعي «ضاعف عدد المساهمات "السيئة" 10 مرات إن لم يكن أكثر» (Ghostty, 2026).
- Godot حظر الوكلاء المستقلين وvibe coding والكود المولَّد بالذكاء الاصطناعي بكميات كبيرة في يونيو 2026، ولم يُبقِ إلا المهام الصغيرة المدعومة مثل إكمال الكود: «لا يستطيع الذكاء الاصطناعي أن يتحمل المسؤولية، ولا يمكننا أن نثق بأن من يعتمدون على الذكاء الاصطناعي بكثافة يفهمون كودهم بما يكفي لإصلاحه» (Godot Foundation, 2026).
- Rust اعتمد سياسة خاصة بالنماذج اللغوية الكبيرة (LLM) لمستودع rust-lang/rust في أغسطس 2026: «لا بأس باستخدام النماذج اللغوية الكبيرة للإجابة عن الأسئلة والتحليل والتلخيص والتحسين والتحقق والاقتراح والمراجعة. لكن ليس للإنشاء» (Rust Blog, 2026).
- GitHub أطلق إعدادات للمستودعات تتيح للمشرفين إيقاف طلبات الدمج أو قصرها على المتعاونين (GitHub, 2026)، ثم أضاف لاحقًا حدًا لعدد طلبات الدمج المفتوحة التي يمكن أن يملكها المساهم الواحد (GitHub, 2026).
ماذا يفعل الذكاء الاصطناعي بمهارات المطورين المبتدئين؟
الكلفة على المبتدئين هي المهارة. من تجربتي، كثيرًا ما يعاني المبتدئون الذين يعتمدون على الذكاء الاصطناعي في الأساسيات، والآن هناك أبحاث عن ذلك، بعضها من شركات الذكاء الاصطناعي نفسها.
أجرت Anthropic تجربة عشوائية على 52 مهندسًا، معظمهم مبتدئون، يتعلمون Trio، وهي مكتبة async في Python لم يستخدموها من قبل. حصلت المجموعة التي استخدمت الذكاء الاصطناعي على 50% في اختبار فهم بعد ذلك. أما المجموعة التي كتبت الكود يدويًا فحصلت على 67%. ولم تكن مجموعة الذكاء الاصطناعي أسرع إلا بنحو دقيقتين، وهو فرق بلا دلالة إحصائية (Anthropic, 2026). خسروا الفهم ولم يحصلوا في المقابل على سرعة قابلة للقياس. تناولت هذه الدراسة بالتفصيل في هل ما زال عليك كتابة الكود يدويًا؟، بما في ذلك طرق استخدام الذكاء الاصطناعي التي حافظت على الدرجات مرتفعة. وللمهندسين ذوي الخبرة الذين يريدون تجنب التراجع نفسه، يشرح مقال كيف تحافظ على مهاراتك البرمجية حين يكتب الذكاء الاصطناعي الكود المهارات التي تضعف أولًا وكيف تتدرب عليها.
يستطيع الذكاء الاصطناعي أن يكتب الكود بدلًا منك، لكن كل ما سبق يوضح لماذا لا بد أن يفهمه أحد. وأرى أن الأساسيات صارت أهم الآن مما كانت عليه من قبل. بنيت LevelUpGo حول كتابة Go بنفسك، من أول سطر حتى كود بيئة الإنتاج، مع تمارين لا تنجح إلا عندما يجتاز كودك الترجمة (compile) وتنجح الاختبارات. واختيار اللغة يساعد أيضًا. يشرح مقال لماذا Go هي أفضل لغة للكود الذي يكتبه الذكاء الاصطناعي كيف يلتقط مترجم Go وأدواتها مزيدًا من أخطاء الوكيل قبل أن تصل إلى بيئة الإنتاج.
هل تسبب أدوات البرمجة بالذكاء الاصطناعي الاحتراق الوظيفي؟
تقول الأبحاث إنها قد تسببه، وغالبًا عبر زيادة عبء العمل والتوقعات التي تأتي معها.
استطلع باحثون في Oregon State University آراء 442 مطورًا محترفًا حول استخدام الذكاء الاصطناعي والاحتراق الوظيفي. ووجدوا أن اعتماد الذكاء الاصطناعي التوليدي يزيد الاحتراق الوظيفي، ويرجع ذلك أساسًا إلى أنه يرفع متطلبات العمل: عبء عمل أكبر وضغط مؤسسي أكبر (Feng et al., 2026). وعبّر مشاركان عن ذلك بوضوح. قال أحدهما: «الأدوات جيدة، أما ما فعلته بتوقعات الإدارة فهو فظيع تمامًا.» وقال الآخر: «أتحرك بسرعة مع الذكاء الاصطناعي وأنجز جبالًا من العمل، لكنني أفقد شغفي بالعمل.»
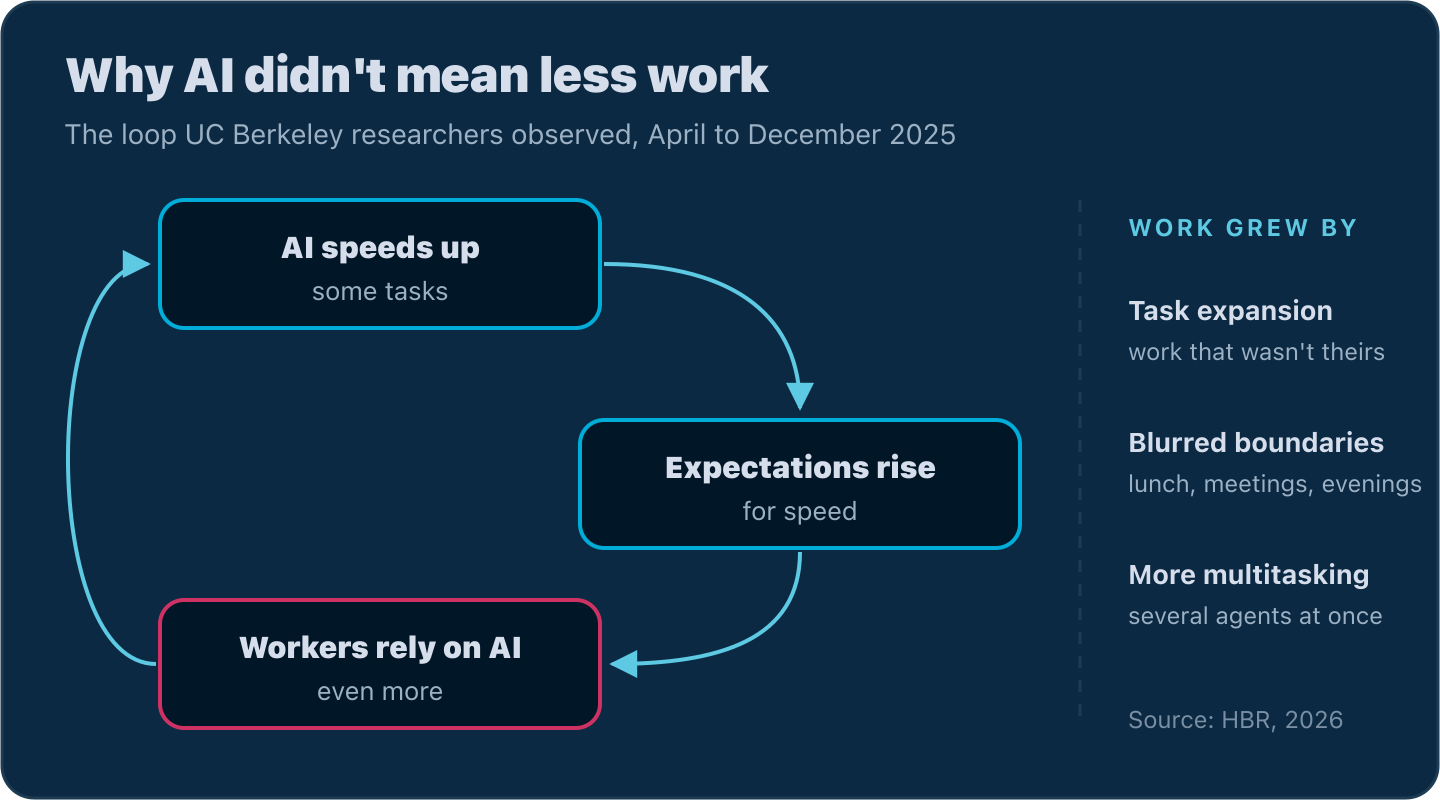
قضى باحثون من UC Berkeley الفترة من أبريل إلى ديسمبر 2025 داخل شركة تقنية أمريكية تضم نحو 200 موظف، يراقبون كيف يعمل الناس فعليًا مع الذكاء الاصطناعي (Harvard Business Review, 2026). وازداد العمل بثلاث طرق:
- توسّع المهام. لأن الذكاء الاصطناعي كان يستطيع سد ما لا يعرفه الناس، بدؤوا يتولون أعمالًا لم تكن يومًا من مسؤوليتهم.
- حدود غير واضحة. صار بدء المهمة رخيصًا إلى حد أن العمل تسلل إلى وقت الغداء والاجتماعات والأمسيات.
- تعدد مهام أكبر. صار الناس يكتبون الكود يدويًا بينما يصوغ الذكاء الاصطناعي نسخة أخرى، ويشغّلون عدة وكلاء في وقت واحد، ويعيدون فتح مهام قديمة لأن الذكاء الاصطناعي صار قادرًا على التعامل معها، دون أن يطلب منهم أحد ذلك.
يصف الباحثون حلقة مفرغة. يسرّع الذكاء الاصطناعي بعض المهام، فترتفع التوقعات بشأن السرعة، فيعتمد العاملون على الذكاء الاصطناعي أكثر. ولخّص أحد المهندسين في الدراسة الأمر قائلًا: «كنت تظن أنك ربما... تستطيع أن تعمل أقل. لكنك في الحقيقة لا تعمل أقل. أنت تعمل القدر نفسه أو أكثر.»
رأيي
يمكن للذكاء الاصطناعي أن يقدم قيمة حقيقية وأن يجعلنا أكثر إنتاجية. أنا أستخدمه كل يوم. لكنه ليس الحل لكل شيء.
ما لفت انتباهي في هذه الدراسات هو مقدار ما يتطابق منها مع ما أراه في العمل. طوال سنواتي كمهندس برمجيات، لم أشعر قط بأن جودة البرمجيات عمومًا منخفضة كما هي الآن. وهذا يعني في رأيي أننا لم نجد بعد التوازن بين السرعة والجودة، وأظن أن الجودة أهم من السرعة.
لذلك أتعامل مع الذكاء الاصطناعي كأداة ترتكب كثيرًا من الأخطاء. أراجع ما يكتبه بدل أن أثق به، ولا أمنحه إلا الصلاحيات التي تحتاجها المهمة، لأنك لا تستطيع تأمين الذكاء الاصطناعي بالـ prompts.
بعد النظر في كل هذه البيانات، ما زلت أسأل نفسي هل الكلفة أعلى من القيمة التي تعيدها هذه الأدوات. ليست لدي إجابة نهائية بعد. لكنني شبه متأكد من أنها أكبر بكثير من سعر الاشتراك.
الأسئلة الشائعة
ما أكبر مخاطر أدوات البرمجة بالذكاء الاصطناعي؟
أكبر المخاطر هي كود يجتاز المراجعة لكنه يفشل في بيئة الإنتاج، ووكلاء لديهم صلاحيات مفرطة يحذفون البيانات، وتراكم في المراجعة يؤدي إلى تحقق أقل دقة، وثغرات أمنية، وفقدان المهارات لدى المطورين الذين يفوّضون تعلمهم. في استطلاع New Relic لعام 2026، استطاع 82% من قادة التقنية أن يذكروا عطلًا في بيئة الإنتاج سببه كود الذكاء الاصطناعي خلال الأشهر الستة السابقة (New Relic, 2026).
لماذا يتعطل الكود المولَّد بالذكاء الاصطناعي في بيئة الإنتاج؟
لا يعرف الوكيل كيف يتصرف نظامك في بيئة الإنتاج. لا يستطيع أن يرى أنماط حركة المرور، ولا أيام الذروة، ولا سبب تعامل الكود الموجود مع حالة حدية بالطريقة التي يتعامل بها، ونادرًا ما يتوقف ليسأل. كما أن الـ diffs الكبيرة التي ينتجها الذكاء الاصطناعي تجعل المراجعين يمرّون عليها سريعًا، فتُعتمد هذه النواقص.
كيف تمنع وكيل الذكاء الاصطناعي من حذف بيانات الإنتاج؟
قيّد ما يستطيع الوصول إليه. امنح الوكلاء بيانات اعتماد منفصلة وضيقة النطاق لكل بيئة، ولا تشارك التخزين أو النسخ الاحتياطية أبدًا بين بيئتي الإنتاج والاختبار، واحفظ حالة Terraform في تخزين بعيد مقفل، واشترط موافقة إنسان على كل أمر تدميري. التعليمات المكتوبة في الـ prompt ليست حدًا أمنيًا.
هل الكود المولَّد بالذكاء الاصطناعي آمن؟
ليس افتراضيًا. ربط مشروع Vibe Security Radar التابع لـ Georgia Tech عدد 35 ثغرة CVE بكود كتبه الذكاء الاصطناعي في مارس 2026 وحده، ويقدّر مؤسس المشروع أن العدد الحقيقي أعلى بخمسة إلى عشرة أضعاف (Infosecurity Magazine, 2026). راجع سطرًا بسطر كل ما يتعلق بالمصادقة والتفويض والمدفوعات، وكل ما يتعامل مع بيانات المستخدمين.
هل ينبغي للمطورين المبتدئين استخدام أدوات البرمجة بالذكاء الاصطناعي؟
استخدمها لشرح المفاهيم والأخطاء، لا لكتابة كود لا تفهمه بعد. في تجربة Anthropic لعام 2026، حصل المبتدئون الذين تعلموا مكتبة جديدة بمساعدة الذكاء الاصطناعي على درجات فهم أقل بـ 17 نقطة، ولم يكونوا أسرع بفارق يُذكر (Anthropic, 2026).
المصادر
- New Relic, 2026 State of AI Coding press release (يونيو 2026)
- Stella Laurenzo, Claude Code is unusable for complex engineering tasks with the Feb updates, GitHub issue #42796 (أبريل 2026)
- Anthropic, April 23 postmortem (أبريل 2026)
- The Register, Cursor Opus agent snuffs out startup's production database (أبريل 2026)
- Alexey Grigorev, How I dropped our production database (مارس 2026)
- The Decoder, AWS AI coding tool decided to delete and recreate a customer-facing system (فبراير 2026)
- Amazon, Response to the Financial Times on the AWS service outage (فبراير 2026)
- Nx, S1ngularity: what happened, how we responded, what we learned (2025)
- StepSecurity, Popular Nx build system package compromised with data-stealing malware (أغسطس 2025)
- Wiz, s1ngularity's aftermath: AI, TTPs, and impact in the Nx supply chain attack (سبتمبر 2025)
- Socket, SANDWORM_MODE: npm worm hijacks CI workflows and poisons AI toolchains (فبراير 2026)
- Faros AI, The AI Acceleration Whiplash: ten takeaways (أبريل 2026)
- Yu et al., Habituation at the Gate: Rising Approval and Declining Scrutiny in Human Review of AI Agent Code (يونيو 2026)
- Sonar, 96% don't fully trust AI output, yet only 48% verify it (يناير 2026)
- Microsoft .NET Blog, Ten months with Copilot coding agent in dotnet/runtime (مارس 2026)
- Georgia Tech, Bad Vibes: AI-generated code is vulnerable, researchers warn (أبريل 2026)
- Infosecurity Magazine, Researchers sound the alarm on vulnerabilities in AI-generated code (مارس 2026)
- GitGuardian, The State of Secrets Sprawl 2026 (مارس 2026)
- Axios, Thousands of AI-built apps exposed sensitive corporate and personal data (مايو 2026)
- CodeScene, AI coding assistants increase defect risk by 30% in unhealthy code (يناير 2026)
- Daniel Stenberg, Death by a thousand slops (يوليو 2025) وThe end of the curl bug-bounty (يناير 2026)
- Ghostty, Updated AI usage policy for contributions, PR #10412 (يناير 2026)
- Godot Foundation, Changes to our contribution policies (يونيو 2026)
- Rust Blog, rust-lang/rust is adopting an LLM policy (أغسطس 2026)
- GitHub Changelog, New repository settings for configuring pull request access (فبراير 2026) وLimit open pull requests for users without write access (يونيو 2026)
- Anthropic, How AI assistance impacts the formation of coding skills (يناير 2026)
- Feng وAfroz وSarma, From Gains to Strains: Modeling Developer Burnout with GenAI Adoption, ICSE-SEIS (2026)
- Ranganathan وYe, AI Doesn't Reduce Work, It Intensifies It, Harvard Business Review (فبراير 2026)