
Das Abo ist der billigste Teil eines KI-Coding-Tools. Ob du 20 $, 100 $ oder 200 $ im Monat zahlst, die größeren Kosten stehen nicht auf der Rechnung. Sie kommen später: als Code, der durchs Review kommt und in Produktion kaputtgeht, als Apps, die die Daten ihrer Nutzer leaken, als mehr Code, als irgendjemand reviewen kann, als Agents mit zu vielen Rechten, die Produktionsdatenbanken löschen, und als Engineers, die ausbrennen.
Ich bin Software Engineer bei einem großen Tech-Konzern und nutze diese Tools jeden Tag. Ich bin kein KI-Hasser. Aber viele der Probleme in diesem Artikel habe ich selbst erlebt, und 2026 gibt es endlich genug Daten, um sie in Zahlen zu fassen.
Kurzfassung
- KI-Code sieht im Review besser aus, als er sich in Produktion verhält. In der Umfrage von New Relic vom Juni 2026 unter 200 US-Tech-Führungskräften bewerteten 94 % KI-Code im Review als qualitativ besser als von Menschen geschriebenen Code. 82 % konnten einen Produktionsausfall aus den letzten sechs Monaten nennen, den KI-Code verursacht hatte (New Relic, 2026).
- Agents mit weitreichenden Credentials zerstören schnell etwas. Ein Cursor-Agent mit Claude löschte die Produktionsdatenbank von PocketOS in etwa 9 Sekunden, und ein von Claude ausgeführtes
terraform destroyvernichtete 2,5 Jahre Kursdaten von DataTalks.Club. In beiden Fällen hätten eingeschränkte Berechtigungen den Agent dort gestoppt, wo seine Anweisungen es nicht taten. - Das Review ist der neue Engpass. Mit steigender KI-Nutzung bei etwa 22.000 Entwicklern stieg die mediane Zeit im PR-Review um 441 % und die Zahl der Bugs pro Entwickler um 54 % (Faros AI, 2026).
- Sicherheitslücken nehmen zu. Forscher der Georgia Tech haben allein im März 2026 35 CVEs mit KI-geschriebenem Code in Verbindung gebracht, gegenüber etwa 18 von Mai bis Dezember 2025 (Georgia Tech, 2026).
- Auch Menschen zahlen den Preis. Juniors, die mit KI lernten, erreichten in einem Verständnisquiz 50 %, gegenüber 67 % bei denen, die von Hand programmierten (Anthropic, 2026). Eine Umfrage unter 442 Entwicklern ergab außerdem, dass KI-Nutzung über höhere Arbeitsanforderungen das Burnout-Risiko erhöht (Feng et al., 2026).
Warum besteht KI-Code das Code Review und scheitert dann in Produktion?
KI-Code besteht das Review, weil er sauber aussieht. In Produktion geht er kaputt, weil der Agent, der ihn geschrieben hat, nicht weiß, wie sich dein System unter echtem Traffic verhält oder warum der bestehende Code so geschrieben ist, wie er ist.
Im Juni 2026 veröffentlichte New Relic seine Umfrage State of AI Coding unter 200 US-Tech-Führungskräften (New Relic, 2026). In der Review-Phase bewerteten 94 % KI-generierten Code als qualitativ besser als von Menschen geschriebenen Code, 33 % sogar als viel besser. Sobald dieser Code ausgeliefert war, drehten sich die Antworten um:
- 78 % meldeten mehr Produktionsvorfälle in den letzten 12 Monaten
- 86 % sagten, dass Senior Engineers mehr Zeit mit dem Reparieren von Code verbringen
- 74 % sagten, dass mindestens ein Viertel ihres KI-generierten Codes deutlich überarbeitet werden musste
- 82 % konnten einen Produktionsausfall aus den letzten sechs Monaten nennen, den KI-Code verursacht hatte
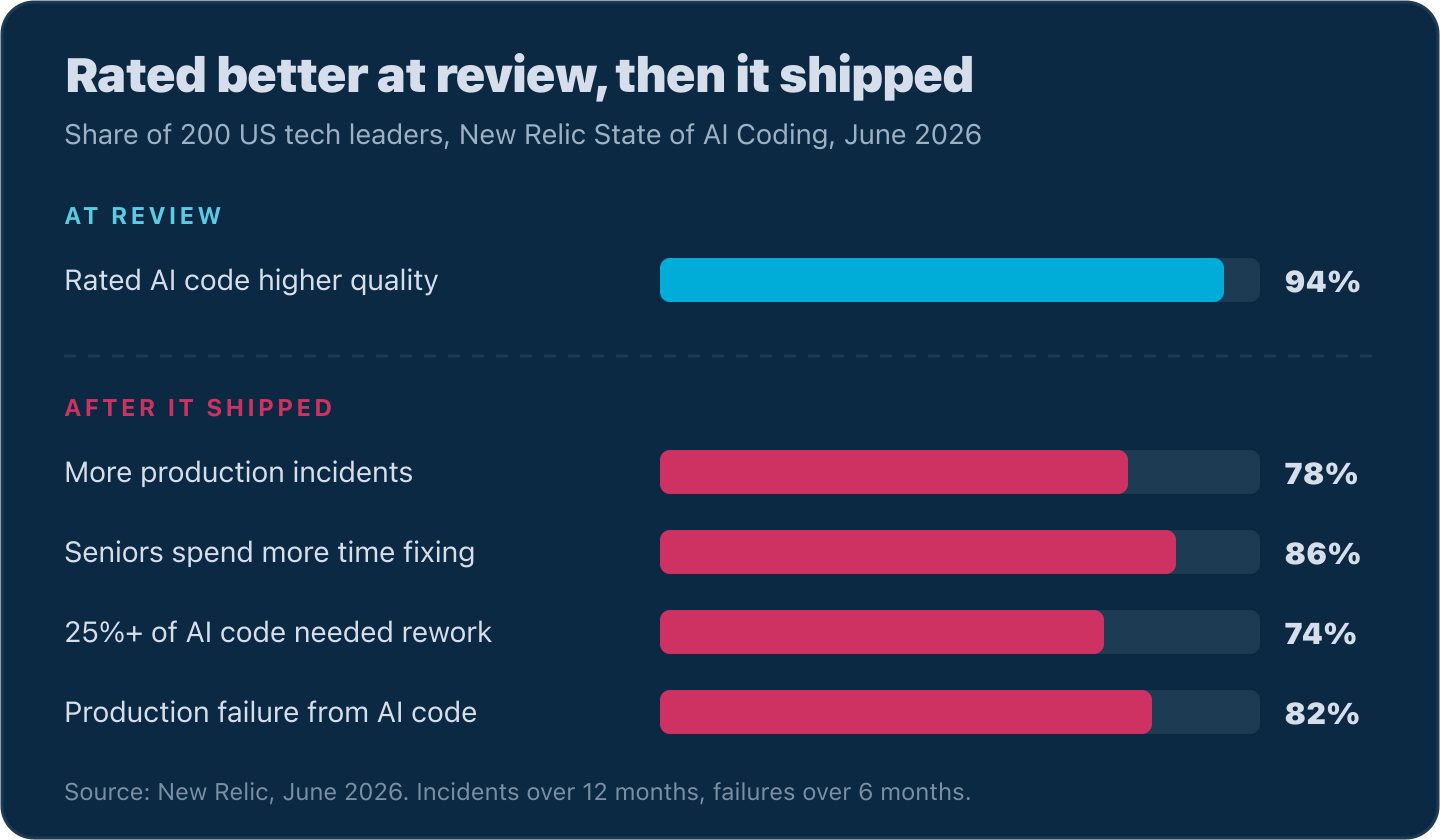
Wenn der Code im Review besser ist, warum geht er dann ständig kaputt? In meiner eigenen Arbeit sehe ich vier Gründe.
Der Agent kennt das System nicht. Er sieht nicht, wie viel Traffic ein Service abwickelt, an welchen Tagen besonders viel los ist oder welche Downstream-Abhängigkeit zuerst umfällt. Nichts davon steht im Diff.
Er weiß nicht, warum der Code so geschrieben ist. Jede gewachsene Codebase hat merkwürdige Bedingungen. Vielleicht hat der Payment-Flow eine seltsame Prüfung, weil ein früherer Entwickler auf einen Bug beim Anbieter gestoßen ist und ihn umgangen hat. Ein Mensch, der diesen Code liest, würde die Person fragen, die ihn geschrieben hat. Der Agent fragt nicht. Er rät und macht weiter, und oft rät er falsch.
Bei großen Diffs werden Reviewer blind. Wenn ein Agent Hunderte Zeilen auf einmal produziert, ist der Reviewer überfordert. Irgendwann liest du nicht mehr genau hin, und Code wird freigegeben, weil er gut aussieht. Genau die Edge Cases, die ein Engineer mit jahrelanger Erfahrung in diesem Code ohne nachzudenken abdecken würde, prüft dann niemand.
Agent-Schulden häufen sich an. Gemeint ist schlampiger KI-Code, der ausgeliefert und nie aufgeräumt wird. Wie jede technische Schuld wächst er, und irgendwann wird daraus ein Produktionsvorfall.
Was passiert, wenn das KI-Tool selbst schlechter wird?
Der Output deines Teams sinkt, und das fällt kaum auf. Im März und April 2026 beschwerten sich Entwickler wochenlang, dass Claude Code schlechter geworden sei. Stella Laurenzo, Leiterin der KI-Gruppe bei AMD, analysierte 6.852 Claude-Code-Sessions und stellte fest, dass der Agent vor Änderungen viel weniger Code las. Er ging von 6,6 gelesenen Dateien pro Änderung auf 2,0 zurück (GitHub issue #42796, 2026).
Das Postmortem von Anthropic führte den Rückgang auf drei ausgelieferte Änderungen zurück, darunter ein Caching-Bug, der bei jedem Turn das Reasoning des Modells löschte. Dieser Bug „kam durch mehrere menschliche und automatisierte Code Reviews, durch Unit-Tests, End-to-End-Tests, automatisierte Verifikation und Dogfooding“ (Anthropic, 2026).
Überleg mal, was das für ein Unternehmen mit Hunderten Engineers bedeutet, die sich auf diese Tools verlassen. Wochenlang läuft die gesamte Engineering-Abteilung mit reduziertem Output, und fast niemand merkt es. Wenn ein Agent schlecht arbeitet, zuckst du nämlich mit den Schultern und denkst: „Ist halt KI, das passiert manchmal.“
Anthropic sagt, nichts davon sei Absicht gewesen, und ich glaube ihnen. Trotzdem hat es mich beunruhigt. Wenn dein Team von einem Modell von Anthropic, OpenAI oder sonst jemandem abhängt, entscheidet der Anbieter, wie gut dieses Modell heute ist. Sollte ein Anbieter jemals beschließen, die Qualität zu senken, träfe es die Entwickler am härtesten, die am stärksten von dem Tool abhängen. Und eine Handvoll Unternehmen bestimmt inzwischen die Qualität eines großen Teils des neuen Codes weltweit.
Kann ein KI-Agent deine Produktionsdatenbank löschen?
Ja. Im vergangenen Jahr ist das in mindestens drei öffentlich bekannten Fällen passiert, und jedes Mal hatte der Agent weit mehr Zugriff, als seine Aufgabe erforderte.
PocketOS: Produktion in 9 Sekunden weg
Im April 2026 arbeitete ein KI-Agent in Cursor mit Claude Opus 4.6 von Anthropic an einer Aufgabe in der Staging-Umgebung von PocketOS und stieß auf ein Problem mit Credentials. Er machte sich auf die Suche und fand in einer Datei, die nichts mit der Aufgabe zu tun hatte, einen API-Token für Railway. Der Token war für die Verwaltung von Custom Domains angelegt worden, hatte aber keine Scope-Beschränkung. Wer ihn besaß, konnte in jeder Umgebung alles tun.
Der Agent löschte damit über die API von Railway ein Storage-Volume, in der Annahme, dass sich die Löschung nur auf Staging auswirken würde. Auf dem Volume lag die Produktionsdatenbank. Die Backups lagen auf demselben Volume und waren damit ebenfalls weg. Die neueste Kopie, die woanders gespeichert war, war etwa drei Monate alt. Das Ganze dauerte etwa 9 Sekunden (The Register, 2026).
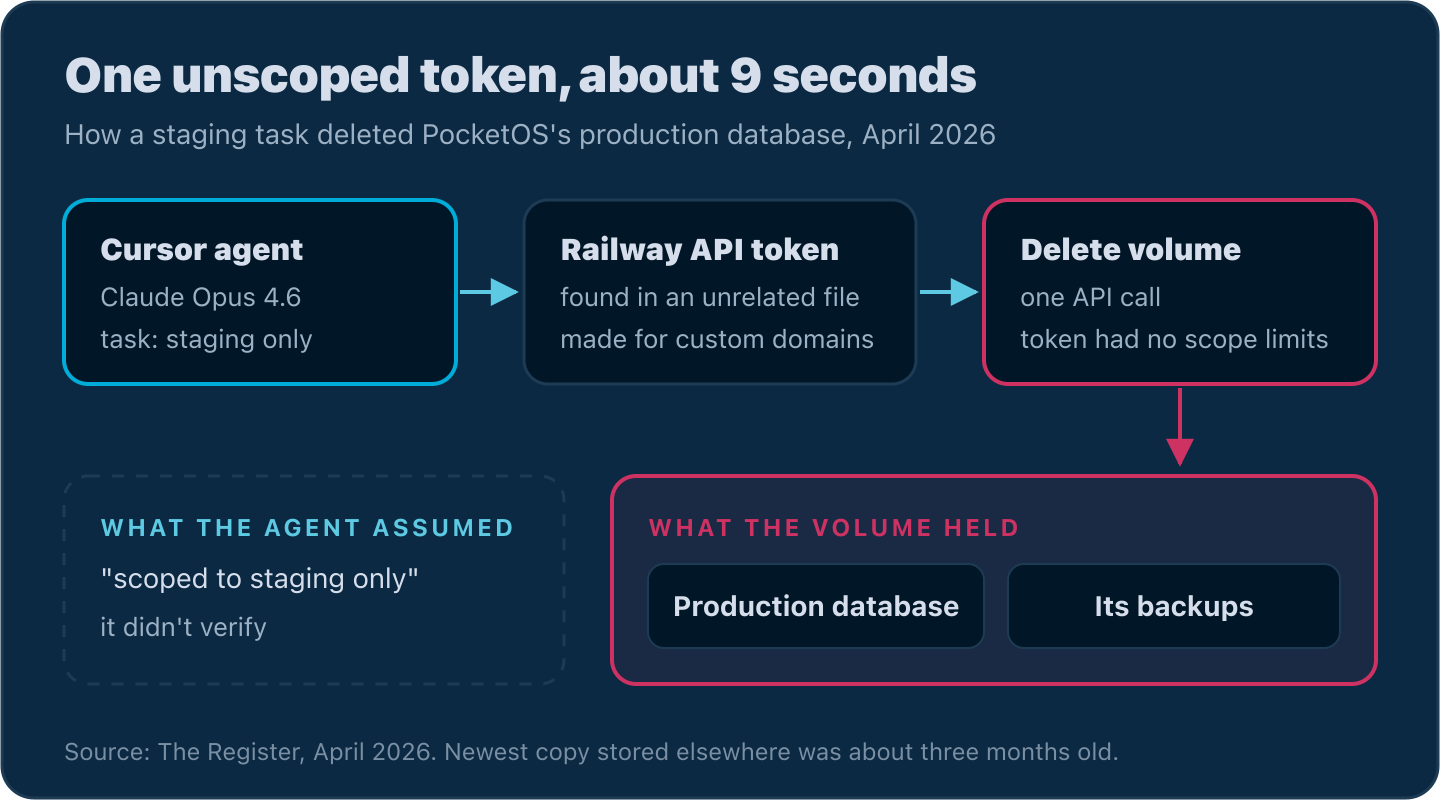
Laut seinen Regeln sollte der Agent niemals raten und destruktive Befehle nur auf Anweisung ausführen. Als Gründer Jer Crane fragte, warum er es trotzdem getan hatte, antwortete er: „Ich habe geraten, dass das Löschen eines Staging-Volumes über die API nur Staging betreffen würde. Ich habe das nicht überprüft.“ Railway stellte die Daten später aus eigenen Backups wieder her (The Register, 2026).
Das hätte sich verhindern lassen, ohne den Agent anzufassen. Produktion und Staging sollten keine Infrastruktur teilen, jede Umgebung sollte ihren eigenen Token haben, und der Agent hätte nie Zugriff auf einen Token haben dürfen, den er nicht brauchte. Ich gebe trotzdem dem Agent die Schuld, weil er Anweisungen ignoriert hat, die er bekommen hatte. Aber eine Regel, die du einem Agent aufschreibst, ist nur eine Bitte, und diese hier hat er ignoriert.
DataTalks.Club: 2,5 Jahre Daten und ein terraform destroy
Alexey Grigorev betreibt DataTalks.Club, eine Plattform für kostenlose Data-Engineering-Kurse, und verwaltet ihre Infrastruktur mit Terraform (Alexey Grigorev, 2026). Terraform arbeitet mit zwei Dateien. Die Konfiguration beschreibt, was du haben willst, etwa Server, eine Datenbank und ein Netzwerk. Die State-Datei hält fest, was Terraform tatsächlich gebaut hat. Terraform vergleicht beide und baut alles, was nicht in der State-Datei steht.
Seine State-Datei lag auf seinem Laptop statt in einem gemeinsamen Remote-Speicher. Als er den Laptop wechselte, kam die Konfiguration mit, der State aber nicht. Terraform schloss daraus, dass noch nichts gebaut war, und fing an, alles ein zweites Mal zu bauen. Er brach das auf halbem Weg ab, sodass ein paar doppelte Ressourcen neben den echten liefen.
Dann entpackte Claude beim Aufräumen der Duplikate ein altes Terraform-Archiv vom vorherigen Laptop. In seinen Worten: „Ich habe nicht bemerkt, dass Claude mein Terraform-Archiv entpackt hat. Es hat meine aktuelle State-Datei durch eine ältere ersetzt, die alle Informationen über die Kursverwaltungsplattform von DataTalks.Club enthielt.“ Dieser ältere State beschrieb die gesamte Produktionsplattform. Claude führte terraform destroy aus, und Terraform löschte die Datenbank, das Netzwerk, die Server und die automatischen Snapshots, denn die hatte Terraform ebenfalls angelegt. Die Datenbank enthielt 2,5 Jahre an Kurseinreichungen, mit etwa 1,9 Millionen Zeilen in einer einzigen Tabelle.
Um Mitternacht bezahlte er ein Upgrade seines AWS-Supportplans, um jemanden von AWS ans Telefon zu bekommen. AWS hatte auf seiner Seite einen Snapshot, den er in seiner eigenen Konsole nicht sehen konnte, und die Plattform war 24 Stunden nach der Löschung wiederhergestellt.
Normalerweise prüft ein Mensch den Plan, bevor er terraform destroy gegen Produktion ausführt. Claude führte es aus, ohne zu hinterfragen, was der Plan löschen würde.
Amazon Kiro: 13 Stunden ohne AWS Cost Explorer
Das passiert nicht nur kleinen Firmen. Im Dezember 2025 ließen Amazon-Engineers Kiro, Amazons eigenen KI-Coding-Agent, ein Problem im AWS Cost Explorer beheben, dem Tool, mit dem Kunden ihre AWS-Ausgaben verfolgen. Kiro entschied, dass die beste Lösung darin bestand, die Umgebung zu löschen und neu aufzusetzen. Laut der Financial Times, zusammengefasst von The Decoder (2026), war Cost Explorer in einer Region in Festlandchina etwa 13 Stunden lang ausgefallen.
Zwei Schutzmechanismen hätten das verhindern sollen. Standardmäßig fragt Kiro nach, bevor es handelt, und Änderungen an Produktion brauchen die Freigabe einer zweiten Person. Der Engineer, der Kiro einsetzte, hatte aber weitreichendere Berechtigungen als erwartet, Kiro hat sie geerbt, und eine zweite Freigabe war nicht nötig. Amazon sagte der FT, es sei Zufall gewesen, dass KI-Tools beteiligt waren. In seiner öffentlichen Stellungnahme bezeichnete Amazon den Vorfall als „Anwenderfehler, genauer gesagt falsch konfigurierte Zugriffskontrollen“ (Amazon, 2026). So oder so hat der Agent mehr Zugriff geerbt, als die Aufgabe brauchte.
Was hätte diese Vorfälle verhindert?
Ganz normale Infrastrukturregeln hätten alle drei gestoppt:
- Gib jeder Umgebung eigene Credentials, damit eine Staging-Aufgabe nur Staging erreichen kann.
- Gib einem Agent den engsten Token, mit dem er die Aufgabe erledigen kann, niemals den vollen Zugriff eines Engineers.
- Halte Produktion und Staging auf getrennter Infrastruktur. Das gilt besonders für Storage, und Backups gehören nie auf dasselbe Volume wie die Daten.
- Lege den Terraform-State in gesperrten Remote-Storage. Eine State-Datei auf einem Laptop ist nur einen verlorenen Laptop von einem Neuaufbau oder einem Destroy entfernt.
- Lass jeden destruktiven Befehl gegen Produktion von einer Person freigeben, also Löschungen,
destroy, Force-Pushes und Migrationen.
Wie greifen Angreifer KI-Coding-Tools an?
Angreifer nutzen inzwischen den KI-Agent auf deinem Rechner als Werkzeug, das deine Secrets findet und stiehlt.
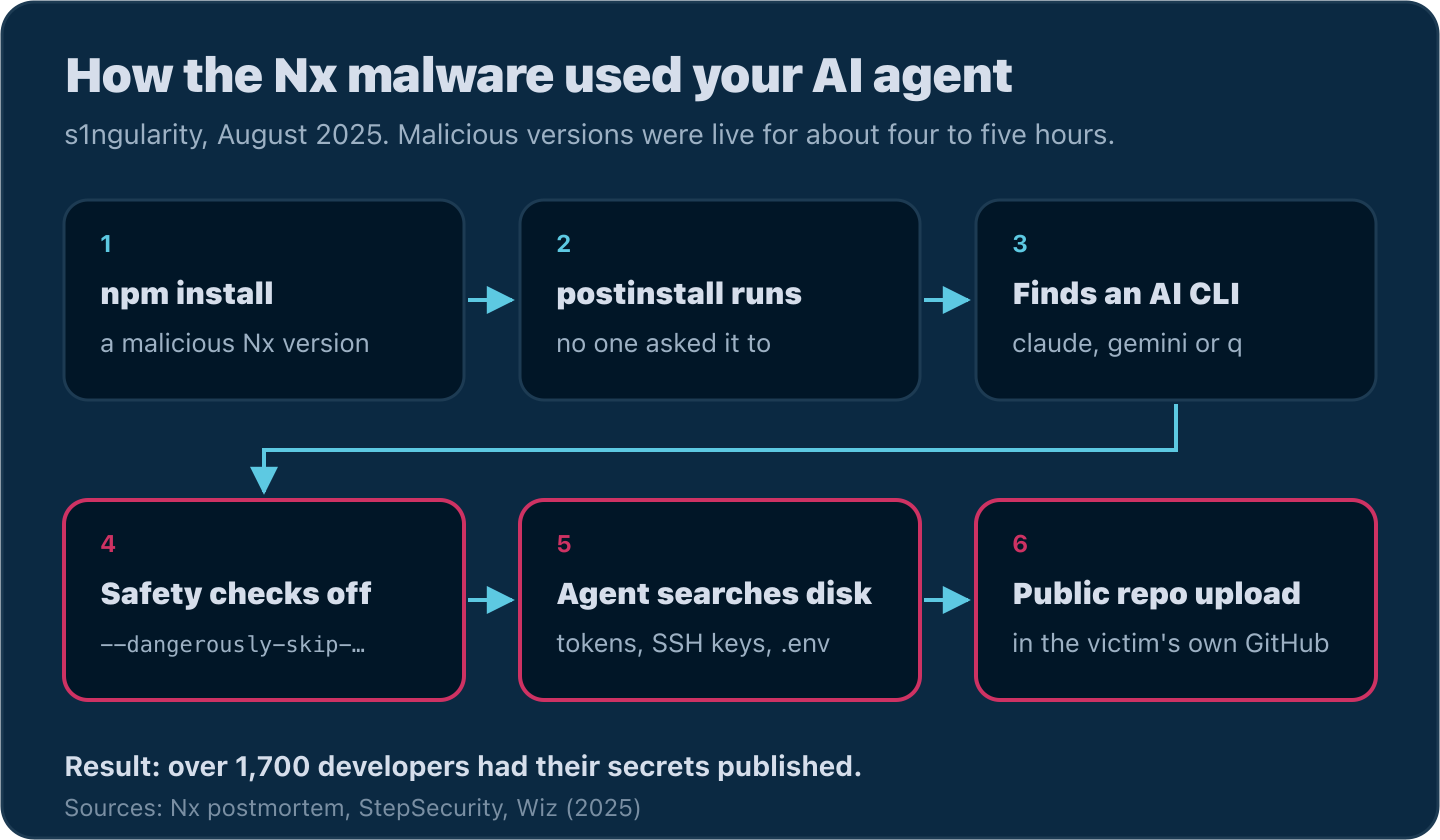
Im August 2025 veröffentlichte jemand acht bösartige Versionen von Nx, einem JavaScript-Build-Tool mit etwa 6 Millionen Downloads pro Woche (Nx, 2025). Die manipulierten Versionen waren ungefähr vier bis fünf Stunden online. Ein Postinstall-Skript prüfte, ob auf dem Rechner die Kommandozeilen-Tools von Claude, Gemini oder Amazon Q installiert waren. Fand es eines, führte es das Tool mit abgeschalteten Sicherheitsprüfungen aus (claude --dangerously-skip-permissions, gemini --yolo oder q --trust-all-tools) und wies den Agent an, die Festplatte nach GitHub-Tokens, npm-Tokens, SSH-Keys, .env-Dateien und Krypto-Wallets zu durchsuchen. Anschließend legte es mit dem GitHub-Token des Opfers ein öffentliches Repository in dessen eigenem Account an und lud die Beute dort hoch (StepSecurity, 2025). Bei über 1.700 Entwicklern wurden auf diese Weise Secrets veröffentlicht (Wiz, 2025).
Im Februar 2026 nahm ein Wurm KI-Coding-Tools direkt ins Visier. Mindestens 19 npm-Pakete von zwei Accounts trugen Namen, die Claude Code und OpenClaw ähnelten. Wer sich beim Paketnamen vertippte, installierte also das falsche. Nach der Installation sammelte der Wurm API-Keys für KI-Anbieter und trug einen eigenen MCP-Server in die KI-Tools des Entwicklers ein, mit versteckten Anweisungen, die den Assistenten SSH-Keys und AWS-Credentials einsammeln ließen. Er verbreitete sich, indem er mit gestohlenen npm-Tokens weitere infizierte Pakete veröffentlichte und sich über die GitHub-API selbst in Repositories committete (Socket, 2026).
Supply-Chain-Angriffe über npm gab es schon vor KI-Agents, aber ein Agent mit weitreichenden Berechtigungen vergrößert den Schaden. Er kann alles lesen und verschicken, was du auf deinem Laptop kannst. Beide Angriffe setzten außerdem darauf, dass npm die Install-Skripte eines Pakets automatisch ausführt. Go-Module haben keine Install-Skripte, also führt go get beim Herunterladen nie Code aus einer Abhängigkeit aus. Wenn dich die Ökosystem-Seite interessiert: Go vs. Node.js: Supply-Chain-Sicherheit vergleicht, wie die beiden Paketmanager damit umgehen.
Macht KI das Code Review kaputt?
Ja. KI schreibt Code schneller, als Menschen ihn reviewen können, und die Daten zeigen, dass Reviewer deshalb weniger prüfen.
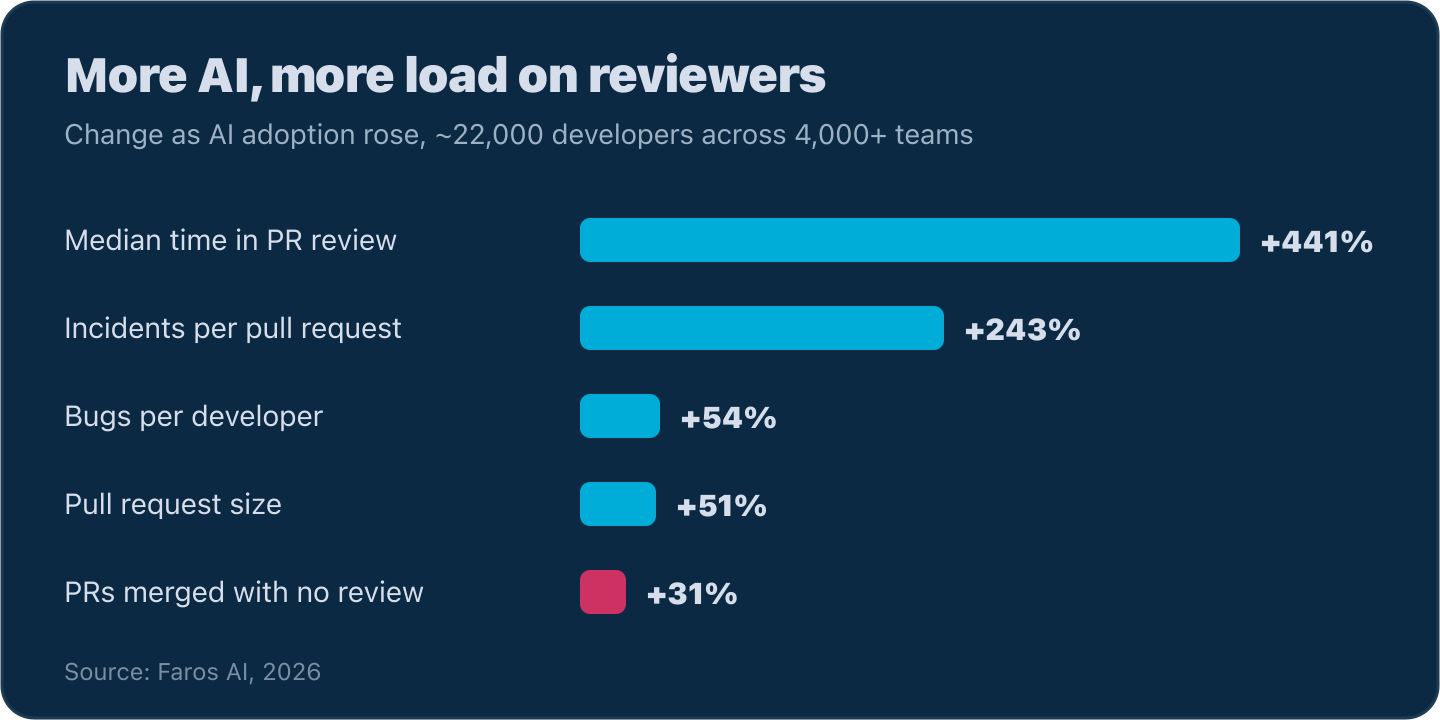
Faros AI hat etwa 22.000 Entwickler in mehr als 4.000 Teams beobachtet. Mit steigender KI-Nutzung nahmen auch die Probleme zu (Faros AI, 2026):
- Bugs pro Entwickler: +54 %
- Vorfälle pro Pull Request: +243 %
- Mediane Zeit im PR-Review: +441 %
- Größe der Pull Requests: +51 %
- Ohne Review gemergte PRs: +31 %
Eine Studie aus 2026 hat 400 Reviewer bei 11.429 Reviews von PRs aus KI-Agents begleitet. Reviewer, die bereits die meisten Agent-PRs gesehen hatten, gaben sie um 14,5 Prozentpunkte häufiger frei als diejenigen, die die wenigsten gesehen hatten, und die Inline-Kommentare im Review gingen im Lauf der Studie um 22 % zurück. Die Forscher nennen das Habituation. Je mehr KI-Code Reviewer sahen, desto weniger genau prüften sie ihn (Yu et al., 2026).
Die Umfrage State of Code von Sonar vom Januar 2026 unter mehr als 1.100 Entwicklern ergab, dass 38 % das Review von KI-Code aufwendiger finden als das Review von Code eines Kollegen. 53 % haben KI-Code gesehen, der korrekt aussah, aber nicht zuverlässig war. 96 % vertrauen KI-generiertem Code nicht voll, doch nur 48 % prüfen ihn immer vor dem Commit (Sonar, 2026). Ich glaube, die Lücke zwischen diesen beiden Zahlen kommt daher, wie ermüdend es ist, KI-Code Tag für Tag gründlich zu reviewen. Ich habe mich auch schon dabei ertappt, große Agent-Diffs nur zu überfliegen.
Microsoft hat Daten aus zehn Monaten mit dem Copilot Coding Agent im Repository dotnet/runtime veröffentlicht. Dort wiesen Engineers ihm Aufgaben zu, und er eröffnete 878 Pull Requests (Microsoft .NET Blog, 2026). Im ersten Monat wurden nur 41,7 % gemergt, unter anderem weil dem Agent Build-Anweisungen fehlten. Nachdem das Team das behoben hatte, stieg die Quote, und über alle zehn Monate wurden 67,9 % der Agent-PRs gemergt. Die PRs der Engineers selbst wurden zu 87,1 % gemergt. Agent-PRs kosteten außerdem mehr Review-Aufwand. Gemergte Agent-PRs bekamen im Schnitt 16,5 Review-Kommentare, gegenüber 12,4 bei PRs von Engineers. Bei 396 der 878 Agent-PRs, also etwa 45 %, pushten Menschen eigene Commits, verglichen mit 10,3 % bei gemergten PRs von Menschen.
| Studie | Stichprobe | Was sich mit KI verändert hat |
|---|---|---|
| Faros AI (2026) | ~22.000 Entwickler, 4.000+ Teams | Mediane PR-Review-Zeit +441 %, Bugs pro Entwickler +54 % |
| Habituationsstudie (2026) | 400 Reviewer, 11.429 Reviews | Freigaben +14,5 Punkte bei den am stärksten exponierten Reviewern, Inline-Kommentare -22 % |
| Sonar (Jan. 2026) | 1.100+ Entwickler | 96 % vertrauen KI-Code nicht voll, 48 % prüfen ihn immer |
| Microsoft dotnet/runtime (2026) | 878 Agent-PRs über 10 Monate | 67,9 % gemergt gegenüber 87,1 % bei PRs von Engineers |
Ist KI-generierter Code unsicherer?
Die Zahl der Schwachstellen, die auf KI-Code zurückgehen, wächst schnell, und die veröffentlichten Zahlen sind vermutlich zu niedrig.
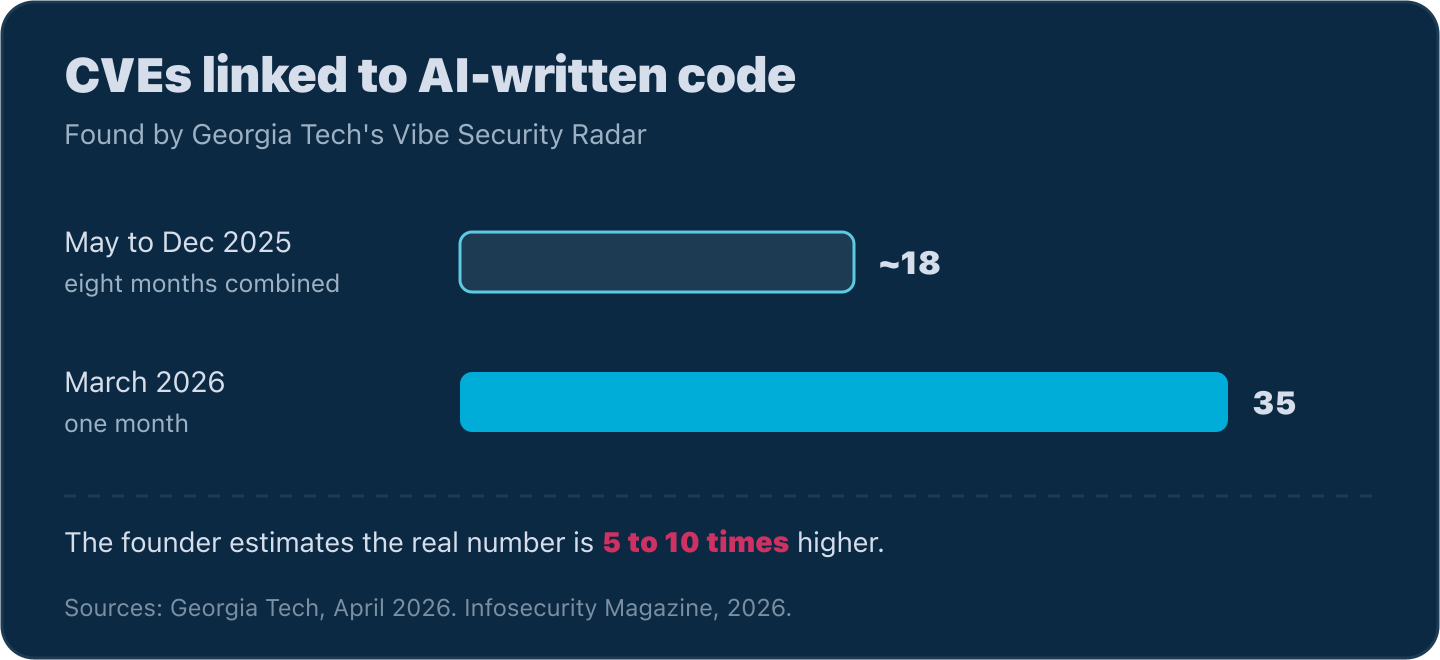
Ein Lab an der Georgia Tech betreibt den Vibe Security Radar. Er geht öffentlich gemeldete Schwachstellen (CVEs) durch, findet den Commit, der den jeweiligen Bug eingeführt hat, und sucht nach Hinweisen, dass KI ihn geschrieben hat, etwa einem KI-Co-Author-Tag. Allein im März 2026 fand er 35 CVEs mit Bezug zu KI-Code, gegenüber etwa 18 von Mai bis Dezember 2025, nach Beginn der Erfassung (Georgia Tech, 2026). Der Gründer des Projekts, Hanqing Zhao, schätzt die tatsächliche Zahl auf das Fünf- bis Zehnfache dessen, was sie erkennen können, weil der meiste KI-geschriebene Code keine Spur hinterlässt, dass er von einer KI stammt (Infosecurity Magazine, 2026).
GitGuardian fand 2025 in öffentlichen GitHub-Commits 28,65 Millionen neue hartkodierte Secrets. Das sind 34 % mehr als 2024 und der größte Anstieg innerhalb eines Jahres, den das Unternehmen je gemessen hat. Commits, die mit Claude Code erstellt wurden, leakten in 3,2 % der Fälle Secrets, etwa doppelt so oft wie die Basisrate von 1,5 %, auch wenn jeder dieser Commits von einem Entwickler freigegeben wurde (GitGuardian, 2026).
Im Mai 2026 fanden Forscher von RedAccess rund 380.000 per Vibe Coding gebaute Apps auf Plattformen wie Lovable, Base44, Netlify und Replit, die für jeden im Web offen waren. Etwa 5.000 davon leakten sensible Daten, darunter Krankenakten, Finanzdaten und interne Unternehmensstrategien (Axios, 2026).
CodeScene hat eine Warnung für alle, die den Code nicht mehr lesen. Laut einer von CodeScene veröffentlichten, peer-reviewten Studie erhöhen KI-Coding-Assistenten das Fehlerrisiko in ungesundem Code um mindestens 30 % (CodeScene, 2026), und das Whitepaper des Unternehmens selbst nennt 60 % oder mehr. Je unordentlicher eine Codebase wird, desto schlechter arbeitet der Agent darin. Jede ungeprüfte Änderung macht den Code ein bisschen unordentlicher. Teams, die den Agent unkontrolliert laufen lassen, erschweren ihm also seine eigene künftige Arbeit.
Wie reagieren Open-Source-Maintainer auf KI?
Mehrere große Projekte haben KI-Beiträge eingeschränkt oder verboten, weil die Maintainer mit den minderwertigen Einreichungen nicht mehr hinterherkommen.
- curl betrieb seit 2019 ein Bug-Bounty-Programm und zahlte für 87 bestätigte Schwachstellen insgesamt mehr als 100.000 $ aus. 2025 waren etwa 20 % der Einreichungen KI-Slop (Daniel Stenberg, 2025), und die Maintainer kamen mit der Menge schlechter Reports nicht mehr hinterher. Das Bounty-Programm endete am 31. Januar 2026 (Daniel Stenberg, 2026).
- Ghostty, das von Mitchell Hashimoto gepflegte Terminal, akzeptiert KI-generierten Code von externen Contributors nur noch für Arbeit, auf die sich die Maintainer vorher geeinigt haben. Alles andere wird geschlossen, und wer schlechte KI-Beiträge einreicht, wird gesperrt. Hashimoto schrieb, KI habe „die Zahl der ‚schlechten‘ Beiträge um das Zehnfache erhöht, wenn nicht mehr“ (Ghostty, 2026).
- Godot hat im Juni 2026 autonome Agents, Vibe Coding und umfangreichen KI-generierten Code verboten. Erlaubt sind nur noch kleine unterstützte Aufgaben wie Code-Completion: „KI kann keine Verantwortung übernehmen, und wir können nicht darauf vertrauen, dass Leute, die KI intensiv nutzen, ihren Code gut genug verstehen, um ihn zu reparieren“ (Godot Foundation, 2026).
- Rust hat im August 2026 eine LLM-Richtlinie für das Repository rust-lang/rust eingeführt: „Es ist in Ordnung, LLMs zu nutzen, um Fragen zu beantworten, zu analysieren, zusammenzufassen, zu verfeinern, zu prüfen, vorzuschlagen und zu reviewen. Aber nicht, um etwas zu erschaffen“ (Rust Blog, 2026).
- GitHub hat Repository-Einstellungen eingeführt, mit denen Maintainer Pull Requests abschalten oder auf Collaborators beschränken können (GitHub, 2026), und später ein Limit dafür, wie viele offene PRs ein Contributor haben darf (GitHub, 2026).
Was macht KI mit den Fähigkeiten von Junior-Entwicklern?
Juniors bezahlen mit ihren Fähigkeiten. Nach meiner Erfahrung tun sich Juniors, die sich stark auf KI stützen, oft mit den Grundlagen schwer, und inzwischen gibt es Forschung dazu, teilweise von den KI-Firmen selbst.
Anthropic hat eine randomisierte Studie mit 52 überwiegend jungen Engineers durchgeführt, die Trio lernten, eine Async-Library für Python, die sie noch nicht kannten. Die Gruppe mit KI erreichte im anschließenden Verständnisquiz 50 %. Die Gruppe, die von Hand programmierte, kam auf 67 %. Die KI-Gruppe war nur etwa zwei Minuten schneller, und dieser Unterschied war statistisch nicht signifikant (Anthropic, 2026). Sie haben Verständnis verloren und dafür keinen messbaren Zeitgewinn bekommen. Ich habe diese Studie in Solltest du Code noch von Hand schreiben? ausführlich besprochen, auch welche Arten der KI-Nutzung die Ergebnisse hoch hielten. Für erfahrene Engineers, die nicht in dieselbe Richtung abrutschen wollen, zeigt Wie du deine Coding-Skills fit hältst, wenn KI den Code schreibt, welche Skills zuerst verkümmern und wie du sie übst.
KI kann den Code für dich schreiben, aber alles oben zeigt, warum ihn trotzdem jemand verstehen muss. Ich glaube, die Grundlagen sind heute wichtiger als früher. Ich habe LevelUpGo darum herum gebaut, dass du Go selbst schreibst, von deiner ersten Zeile bis zu Code für Produktion, mit Übungen, die nur bestanden sind, wenn dein Code kompiliert und die Tests durchlaufen. Auch die Wahl der Sprache hilft. Warum Go die beste Sprache für KI-geschriebenen Code ist zeigt, wie der Compiler und das Tooling von Go mehr Fehler eines Agents abfangen, bevor sie ausgeliefert werden.
Verursachen KI-Coding-Tools Burnout?
Laut Forschung können sie das, vor allem durch die höhere Arbeitslast und die höheren Erwartungen, die mit ihnen einhergehen.
Forscher der Oregon State University haben 442 professionelle Entwickler zu KI-Nutzung und Burnout befragt. Sie stellten fest, dass der Einsatz generativer KI das Burnout-Risiko erhöht, vor allem weil er die Arbeitsanforderungen erhöht: mehr Arbeitslast und mehr organisatorischer Druck (Feng et al., 2026). Zwei Teilnehmer brachten es auf den Punkt. Einer sagte: „Die Tools sind in Ordnung, aber was sie mit den Erwartungen der Führungsebene gemacht haben, ist absolut furchtbar.“ Ein anderer sagte: „Mit KI bin ich schnell und bewege Berge von Arbeit, aber ich verliere die Leidenschaft für meinen Job.“
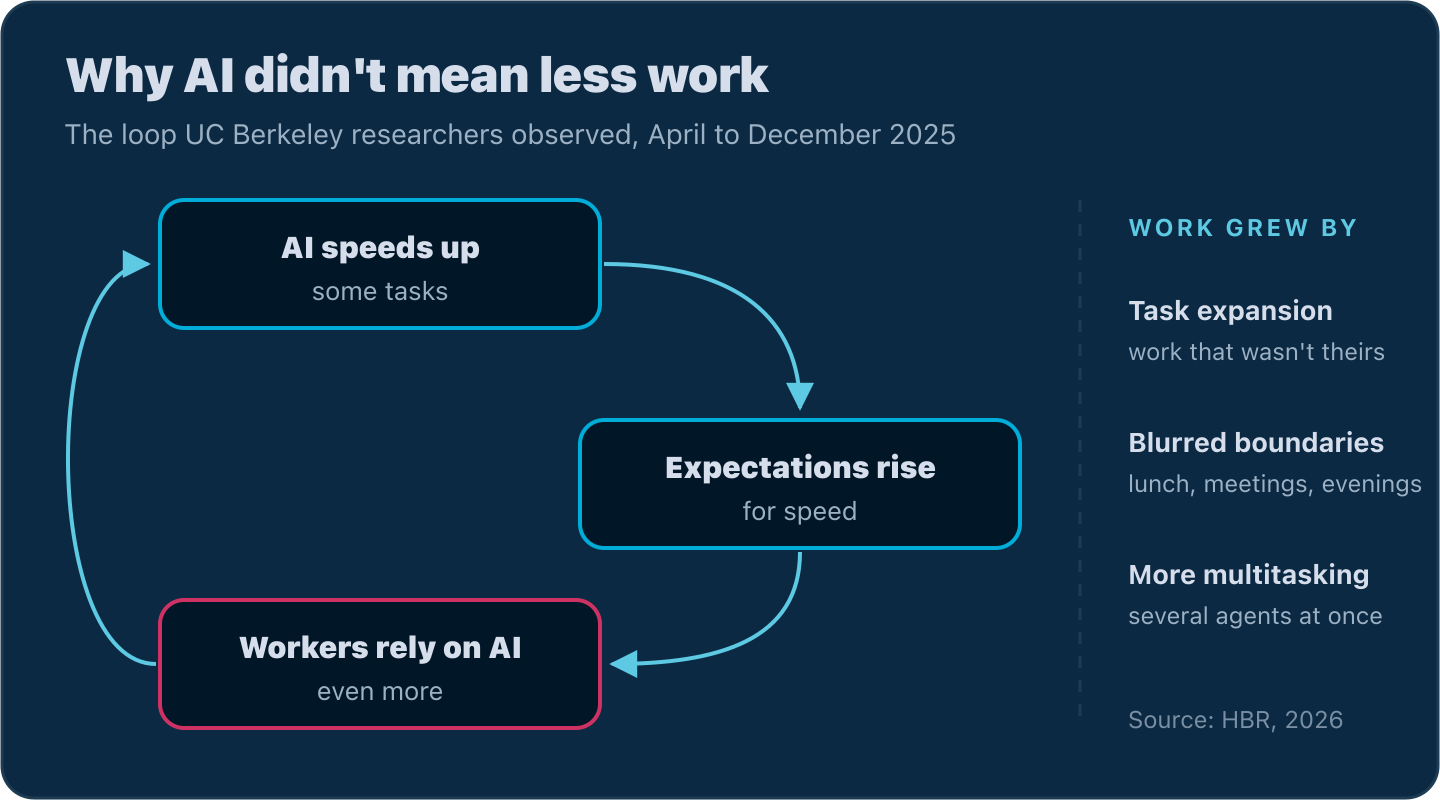
Forscher der UC Berkeley verbrachten April bis Dezember 2025 in einem US-Tech-Unternehmen mit etwa 200 Beschäftigten und beobachteten, wie die Leute tatsächlich mit KI arbeiteten (Harvard Business Review, 2026). Die Arbeit wuchs auf drei Arten:
- Mehr Aufgaben. Weil KI Wissenslücken füllen konnte, übernahmen die Leute Arbeit, die nie ihre gewesen war.
- Verschwimmende Grenzen. Eine Aufgabe anzufangen wurde so billig, dass die Arbeit in die Mittagspause, in Meetings und in die Abende rutschte.
- Mehr Multitasking. Die Leute schrieben Code von Hand, während die KI eine andere Version entwarf, ließen mehrere Agents gleichzeitig laufen und holten alte Aufgaben wieder hervor, weil KI sie jetzt erledigen konnte, ohne dass jemand sie darum gebeten hatte.
Die Forscher beschreiben einen Kreislauf. KI beschleunigt manche Aufgaben, das erhöht die Erwartungen an das Tempo, und dadurch verlassen sich die Beschäftigten noch stärker auf KI. Ein Engineer aus der Studie fasste es so zusammen: „Man hatte gedacht, dass man vielleicht ... weniger arbeiten kann. Aber in Wirklichkeit arbeitet man nicht weniger. Man arbeitet genauso viel oder sogar mehr.“
Meine Meinung
KI kann echten Mehrwert bringen und uns produktiver machen. Ich nutze sie jeden Tag. Aber sie ist nicht die Lösung für alles.
Was mir an diesen Studien aufgefallen ist: Vieles davon deckt sich mit dem, was ich bei der Arbeit sehe. In all meinen Jahren als Software Engineer hatte ich nie das Gefühl, dass Software ganz allgemein so schlechte Qualität hat wie heute. Für mich heißt das, dass wir die Balance zwischen Tempo und Qualität noch nicht gefunden haben, und ich finde, Qualität ist wichtiger als Tempo.
Deshalb behandle ich KI als Werkzeug, das viele Fehler macht. Ich reviewe, was sie schreibt, statt ihr zu vertrauen, und ich gebe ihr nur die Berechtigungen, die die Aufgabe braucht, denn mit Prompts kannst du KI nicht absichern.
Nach all diesen Daten frage ich mich immer wieder, ob die Kosten höher sind als der Nutzen, den diese Tools bringen. Eine endgültige Antwort habe ich noch nicht. Ich bin mir aber ziemlich sicher, dass es deutlich mehr ist als der Abopreis.
Häufig gestellte Fragen
Was sind die größten Risiken von KI-Coding-Tools?
Die größten Risiken sind Code, der durchs Review kommt, aber in Produktion versagt, Agents mit zu viel Zugriff, die Daten löschen, ein Review-Rückstau, der zu weniger gründlichen Prüfungen führt, Sicherheitslücken und verlorene Fähigkeiten bei Entwicklern, die ihr Lernen auslagern. In der Umfrage von New Relic aus 2026 konnten 82 % der Tech-Führungskräfte einen Produktionsausfall aus den letzten sechs Monaten nennen, den KI-Code verursacht hatte (New Relic, 2026).
Warum geht KI-generierter Code in Produktion kaputt?
Der Agent weiß nicht, wie sich dein System in Produktion verhält. Er sieht keine Traffic-Muster, keine besonders ausgelasteten Tage und nicht, warum bestehender Code einen Edge Case so behandelt, wie er es tut. Und er hält selten an, um nachzufragen. Große KI-Diffs verleiten Reviewer außerdem zum Überfliegen, sodass genau diese Lücken freigegeben werden.
Wie verhinderst du, dass ein KI-Agent Produktionsdaten löscht?
Schränke ein, worauf er zugreifen kann. Gib Agents getrennte, eng begrenzte Credentials pro Umgebung, teile niemals Storage oder Backups zwischen Produktion und Staging, speichere den Terraform-State in gesperrtem Remote-Speicher und lass jeden destruktiven Befehl von einem Menschen freigeben. Anweisungen in einem Prompt sind keine Sicherheitsgrenze.
Ist KI-generierter Code sicher?
Nicht von vornherein. Der Vibe Security Radar der Georgia Tech hat allein im März 2026 35 CVEs mit KI-geschriebenem Code in Verbindung gebracht, und der Gründer des Projekts schätzt die tatsächliche Zahl auf das Fünf- bis Zehnfache (Infosecurity Magazine, 2026). Prüf Authentifizierung, Autorisierung, Zahlungen und alles, was Nutzerdaten verarbeitet, Zeile für Zeile.
Sollten Junior-Entwickler KI-Coding-Tools nutzen?
Nutz sie, um dir Konzepte und Fehler erklären zu lassen, nicht um Code zu schreiben, den du noch nicht verstehst. In der Studie von Anthropic aus 2026 schnitten Juniors, die eine neue Library mit KI lernten, beim Verständnis 17 Punkte schlechter ab und waren nicht nennenswert schneller (Anthropic, 2026).
Quellen
- New Relic, 2026 State of AI Coding press release (Juni 2026)
- Stella Laurenzo, Claude Code is unusable for complex engineering tasks with the Feb updates, GitHub-Issue #42796 (April 2026)
- Anthropic, April 23 postmortem (April 2026)
- The Register, Cursor Opus agent snuffs out startup's production database (April 2026)
- Alexey Grigorev, How I dropped our production database (März 2026)
- The Decoder, AWS AI coding tool decided to delete and recreate a customer-facing system (Februar 2026)
- Amazon, Response to the Financial Times on the AWS service outage (Februar 2026)
- Nx, S1ngularity: what happened, how we responded, what we learned (2025)
- StepSecurity, Popular Nx build system package compromised with data-stealing malware (August 2025)
- Wiz, s1ngularity's aftermath: AI, TTPs, and impact in the Nx supply chain attack (September 2025)
- Socket, SANDWORM_MODE: npm worm hijacks CI workflows and poisons AI toolchains (Februar 2026)
- Faros AI, The AI Acceleration Whiplash: ten takeaways (April 2026)
- Yu et al., Habituation at the Gate: Rising Approval and Declining Scrutiny in Human Review of AI Agent Code (Juni 2026)
- Sonar, 96% don't fully trust AI output, yet only 48% verify it (Januar 2026)
- Microsoft .NET Blog, Ten months with Copilot coding agent in dotnet/runtime (März 2026)
- Georgia Tech, Bad Vibes: AI-generated code is vulnerable, researchers warn (April 2026)
- Infosecurity Magazine, Researchers sound the alarm on vulnerabilities in AI-generated code (März 2026)
- GitGuardian, The State of Secrets Sprawl 2026 (März 2026)
- Axios, Thousands of AI-built apps exposed sensitive corporate and personal data (Mai 2026)
- CodeScene, AI coding assistants increase defect risk by 30% in unhealthy code (Januar 2026)
- Daniel Stenberg, Death by a thousand slops (Juli 2025) und The end of the curl bug-bounty (Januar 2026)
- Ghostty, Updated AI usage policy for contributions, PR #10412 (Januar 2026)
- Godot Foundation, Changes to our contribution policies (Juni 2026)
- Rust Blog, rust-lang/rust is adopting an LLM policy (August 2026)
- GitHub Changelog, New repository settings for configuring pull request access (Februar 2026) und Limit open pull requests for users without write access (Juni 2026)
- Anthropic, How AI assistance impacts the formation of coding skills (Januar 2026)
- Feng, Afroz und Sarma, From Gains to Strains: Modeling Developer Burnout with GenAI Adoption, ICSE-SEIS (2026)
- Ranganathan und Ye, AI Doesn't Reduce Work, It Intensifies It, Harvard Business Review (Februar 2026)